
 138
 2
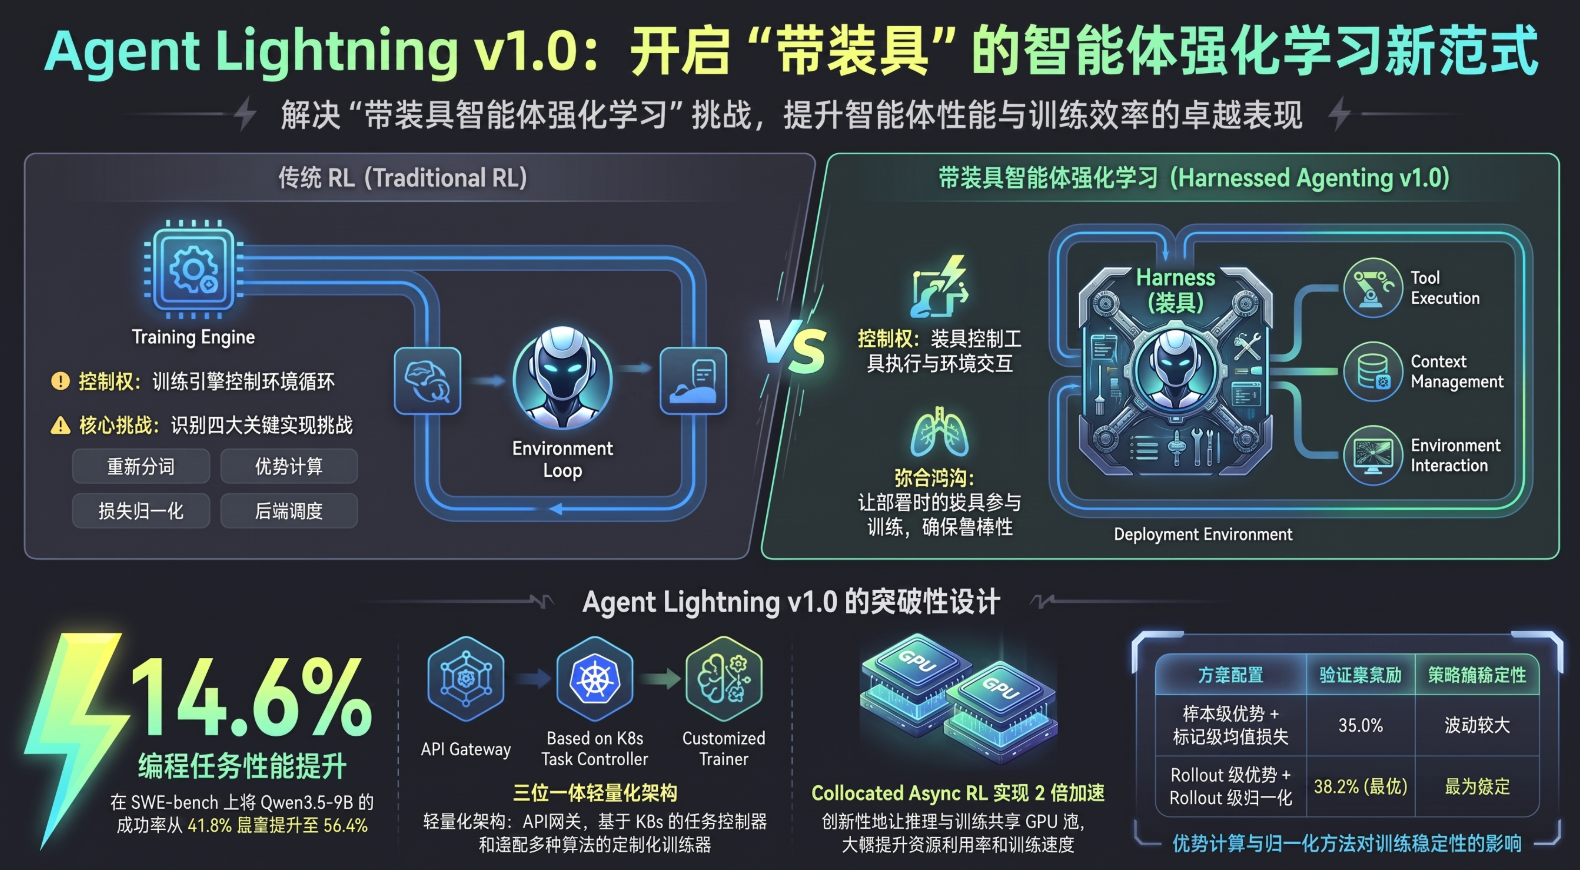
本文档《Agent Lightning v1.0: Towards Harnessed Agentic RL》概述了 Agent Lightning v1.0,这是一个旨在解决“受控代理强化学习”(Harnessed Agentic RL, HARL)挑战的轻量级框架。与传统代理强化学习(RL)不同,HARL 范式中,代理的部署环境(即“Harness”,负责管理工具、上下文和控制流)直接参与模型的训练,从而缩小了训练与实际使用之间的差距。
核心发现与成就:
范式转移: 确定了 HARL 与传统 RL 的根本区别——在 HARL 中,支架(Harness)拥有环境交互循环,而训练引擎仅观察到一系列 LLM 请求-响应对。
技术挑战: 系统性地阐述了重新分词(Retokenization)、样本合并、优势计算、损失归一化以及后端调度等关键挑战。
框架优势: Agent Lightning v1.0 仅用约 3,500 行代码实现,支持任意代理支架,并引入了“同址异步 RL”(Collocated Async RL)以提高 GPU 利用率。
显著性能提升: 在编码代理任务中,仅使用 6,000 个训练样本,便将 Qwen3.5-9B 在 SWE-bench Verified 上的表现从 41.8% 提升至 56.4%,实现了 14.6% 的绝对增长。
1. 核心概念:受控代理强化学习 (Harnessed Agentic RL)
现代 AI 代理并非作为独立的 LLM 运行,而是在管理工具、执行环境和控制流的“代理支架”(Agent Harness)内运行。
1.1 传统代理 RL vs. 受控代理 RL
特性
传统代理 RL
受控代理 RL (HARL)
交互所有权
训练引擎拥有环境交互循环
代理支架(Harness)拥有该循环
状态观察
策略模型直接与环境交互,观察连续令牌历史
策略模型仅观察由支架构建的独立请求提示词
潜在状态
主要是环境状态
包含支架状态 + 环境状态
数据表现形式
单一线性令牌轨迹
一系列请求-响应对 $(p_1, a_1), (p_2, a_2), \dots$
1.2 支架的核心作用
支架决定了代理如何观察环境、跨长周期执行行动以及从错误中恢复。常见的支架包括用于编码的 mini-SWE-agent、OpenHands,以及通用支架 OpenClaw 和 Hermes。
2. 受控代理 RL 面临的主要挑战
研究识别出四个影响算法正确性和训练稳定性的关键挑战:
2.1 重新分词与样本合并 (Retokenization & Sample Merging)
令牌前缀断裂: 即使文本内容相同,重新分词(Retokenization)后的令牌 ID 可能会发生变化。这通常由聊天模板的非组合性、解码-再分词漂移或推理时的输出转换(如 JSON 修复)引起。
后果: 导致连续调用无法安全合并,增加了计算冗余。
2.2 优势计算 (Advantage Calculation)
动态样本数: 由于重新分词、子代理产生或上下文摘要,一个任务级的 Rollout 可能会产生多个训练样本。
统计偏差: 如果在样本层级计算优势,会给产生更多样本的 Rollout 分配更高的权重。研究认为 Rollout 层级的优势计算 是更原则性的选择。
2.3 损失归一化 (Loss Normalization)
不稳定性: 如果按样本层级归一化损失,会导致训练不稳定。
推荐方案: 采用 Rollout 层级的令牌平均损失(Rollout-level token-mean loss),确保每个 Rollout 在梯度更新中具有相等的权重,不受其产生的样本数量影响。
2.4 训练后端调度
由于 Rollout 产生的样本数量和长度只有在执行后才能确定,后端必须在固定的 GPU 集群上动态平衡多变的工作负载,同时保持 Rollout 的统计完整性。
3. Agent Lightning v1.0 系统设计
Agent Lightning v1.0 采用解耦架构,通过以下三个主要组件协调训练与执行:
3.1 架构组件
API 网关 (API Gateway): 充当事实来源,存储 Rollout 状态和事件。它作为 LLM 代理转发请求,并自动记录模型交互事件。
Rollout 控制器 (Rollout Controller): 管理代理的执行。它支持 Kubernetes (K8s) 集群,将每个代理任务调度为标准的 K8s Job,避免了对昂贵的商业沙盒服务的依赖。
自定义训练器 (Customized Trainer): 基于 VERL 构建,负责注册 Rollout、检索轨迹并组装训练样本。
3.2 关键技术特性
同址异步 RL (Collocated Async RL): 允许 Rollout 和权重更新共享同一组 GPU 池。当收集到足够数据时切换到更新阶段,API 网关会暂停新请求。相比同步 RL,实现了约 2 倍的端到端加速。
网络鲁棒性: 设计了幂等的 API 端点,并能通过提示词去重来处理网络重试导致的重复 LLM 调用。
简单性原则: 整个框架代码量约为 3,500 行,易于扩展和研究。
4. 实验结果与验证
4.1 编码代理 (Coding Agent) 案例研究
这是本研究的重点,展示了在资源有限的情况下实现显著性能提升的路径。
数据处理: 使用 SWE-smith 数据集,通过过滤空说明、缺失分支和过大测试套件,最终筛选出约 6,000 个高质量训练样本。
奖励欺骗 (Reward Hacking) 防护:
禁用 Git 命令并隐藏
.git目录,防止模型查看提交历史。实施 K8s 网络策略,屏蔽通用的外部网络访问。
训练表现:
SWE-bench Verified 提升: Qwen3.5-9B 从 41.8% 提升至 56.4%。
策略稳定性: 实验验证了 Rollout 层级的优势计算和损失归一化能提供最高且最稳定的验证集奖励。
4.2 其他代理类型
搜索代理 (Search Agent): 在 HotpotQA 等多跳问答任务上,验证集奖励从 25.1% 提升至 41.7%。
通用指令遵循代理: 在多样化的计算机沙盒任务中,验证集奖励从 51.9% 提升至 70.2%。
5. 结论
Agent Lightning v1.0 为受控代理强化学习提供了一个高效且透明的测试床。通过系统性地处理 HARL 特有的建模挑战(如 Rollout 层级的统计处理),该框架证明了即便使用中等规模的计算资源和开源模型,也能在复杂的软件工程任务中取得突破性进展。该项目已在 GitHub 开源,以促进该领域的可重现性研究。