
 1
 0
今天的这篇的主题是: RoboTTT: Context Scaling for Robot Policies
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
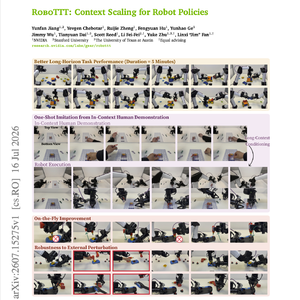
近期的机器人基础模型通常在单步或短历史的视觉运动(visuomotor)上下文下运行。我们推出了测试时训练机器人策略(RoboTTT),这是一种将视觉运动上下文扩展至 8K 个时间步(比现有最先进策略高出三个数量级)且不会增加推理延迟的机器人模型与训练方案。在这种上下文长度下,我们解锁了全新的机器人能力:从人类视频演示中实现单样本即时上下文模仿(one-shot in-context imitation)、实时策略改进、对扰动的鲁棒性,以及在多阶段、长视角(long-horizon)任务中更强的表现。此外,我们还首次观察到随着预训练上下文长度的扩展,闭环性能获得了稳步提升。
RoboTTT 的核心在于将测试时训练(Test-Time Training)集成到诸如视觉-语言-动作(Vision-Language-Action)策略等机器人基础模型中,构建出一个序列模型,其循环状态(recurrent state)由“快速权重”(fast weights)构成——即在训练和推理过程中均通过梯度下降更新的参数,将历史信息压缩至权重空间,并为长上下文条件化检索上下文信息。为了扩展训练上下文长度,该方案结合了序列动作强制(sequence action forcing)与截断按时间反向传播(truncated backpropagation through time)。
在具挑战性的真实机器人操控任务中,RoboTTT 相比单步上下文基线将整体性能提升了 87%,并完整完成了一项耗时 5 分钟、包含 10 个阶段的装配任务,而无任何基线模型能够做到这一点。使用 8K 时间步上下文训练的 RoboTTT 比使用 1K 时间步预训练的同一模型性能高出 62%,这表明上下文长度可以作为机器人基础模型的一个全新扩展轴(scaling axis)。
原文链接:arxiv.org
