
 3
 0
今天的这篇的主题是: DataSpace: Benchmarking Data Agents for Verifiable Analytics over Heterogeneous Workspaces
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
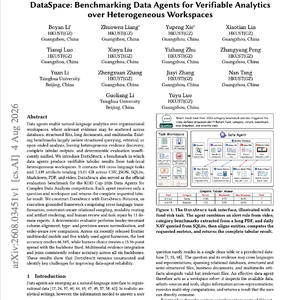
数据智能体(Data agents)使得跨组织工作空间进行自然语言分析成为可能,而在这些空间中,相关证据可能分散在数据库、结构化文件、长文档和多媒体中。现有的基准测试在很大程度上孤立了结构化查询、检索或开放式分析,导致异构证据发现、完整的表格输出以及确定性评估之间缺乏充分统一。我们提出了 DataSpace,这是一个让数据智能体从任务局部的异构工作空间中生成可验证表格结果的基准测试。它包含 410 个跨语言任务和 7,439 个构件(artifacts),涵盖 CSV、JSON、SQLite、Markdown、PDF 和视频,总计 15.01 GB。DataSpace 还作为 KDD Cup 2026“用于复杂数据分析的数据智能体”竞赛的官方评估基准。每个智能体仅接收一个问题和工作空间,并返回请求的完整表格结果。我们使用 DataSpace-Builder 构建了 DataSpace,这是一个基于执行的框架,包含跨语言转换、约束感知关系采样、模态路由与构件渲染,以及由 11 位领域专家进行的人工审查与任务修复。确定性评估器执行表头无关的列对齐、类型与精度感知的归一化,以及顺序感知的行比较。在对 6 个最新发布的前沿多模态模型和 5 个广泛使用的智能体框架(harnesses)进行的评估中,最高准确率达到了 66.34%,而在主干模型固定的情况下,框架的选择产生了 15.36 个百分点的差距。多模态证据集成与连接(joins)一致降低了所有 6 个主干模型的准确率。这些结果表明 DataSpace 仍未饱和,并指出了提升数据智能体可靠性的关键挑战。
原文链接:arxiv.org
