
 2
 0
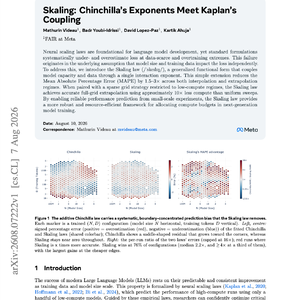
今天的这篇的主题是: Skaling: Chinchilla’s Exponents Meet Kaplan’s Coupling
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
神经缩放定律(neural scaling laws)是语言模型开发的基础,然而标准公式在数据稀缺和过训练(overtraining)的极值情况下,会系统性地低估和高估损失(loss)。这一缺陷源于其底层假设,即模型大小和训练数据对损失的影响是彼此独立的。为了解决这一问题,我们提出了 Skaling 定律,这是一种通过单一交互指数将模型容量与数据耦合起来的广义函数形式。这种简单的扩展将内插和外推范畴内的平均绝对百分比误差(MAPE)降低了 1.5 到 3 倍。当与限制在低算力范畴内的稀疏网格策略结合使用时,Skaling 定律利用比均匀扫描(uniform sweeps)少约 10 倍的算力实现了准确的全网格外推。通过支持从小规模实验中进行可靠的性能预测,Skaling 定律为下一代模型训练中的算力预算分配提供了一个更具鲁棒性且资源利用率更高的框架。
原文链接:arxiv.org
