

 19
 1
模型越来越强,为什么还要从头做一个开源 AI 客户端?
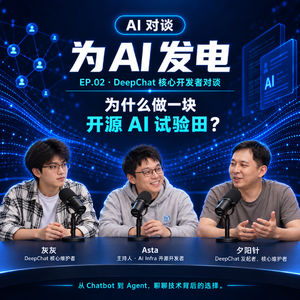
《为 AI 发电》第二期,Asta 和 DeepChat 的两位核心维护者——杨老师、灰灰——聊了聊这个项目从搜索型 Chatbot 走向 Agent 客户端的过程,也聊了聊开源项目怎样在快速变化的 AI 生态里找到自己的位置。
DeepChat 最初解决的是一个很具体的问题:把模型、搜索和本地电脑能力放进一个自己能掌控的桌面客户端。随着模型接口、流式 Markdown 渲染、供应商适配、工具调用和上下文管理不断变复杂,它也逐渐从“把答案整理出来”的 Chatbot,变成了需要处理 Harness、Memory、Sandbox、MCP 和 ACP 的 Agent 客户端。
这期里,两位嘉宾没有只讲功能清单,而是把许多工程取舍摊开来聊:Tape 怎样把零散的上下文处理经验组织起来;Memory 为什么在科研、日常对话、项目管理和代码重构中有不同的价值;桌面端为什么会遇到 Electron、内存、CPU、并发和沙箱的问题;面对 Cherry Studio、DeepSeek Harness 等不同路线的客户端,DeepChat 为什么仍然愿意快速尝试新技术。
后半段回到开发者的日常工作:晚上给 Agent 布置架构分析和重构任务,早上检查结果;把代码 Review 放进一台真正能运行项目的机器;让 CI、打包、上传和重复性维护交给 Agent。一个很实用的判断也出现在这里:同一句 Prompt 如果已经输入了三次,就该考虑把它沉淀成 Skill、定时任务或 webhook 流程。
最后,我们聊到 AI 时代的开源贡献。生成代码降低了提交 PR 的门槛,却没有减少理解问题、验证改动和尊重维护者时间的责任。对开源项目来说,真正有价值的贡献,仍然从“我知道自己在提交什么”开始。
本期你会听到
- DeepChat 为什么从头做一个开源桌面 AI 客户端。
- 杨老师和灰灰各自怎样从小修小改走进开源社区。
- DeepChat 如何从搜索型 Chatbot 演进到 Agent 客户端。
- 流式 Markdown、模型供应商适配,以及模型接口不一致带来的工程工作。
- Tape、Harness 和 Memory 分别在解决什么问题。
- Memory 为什么适合项目管理,却不一定适合每一次编码任务。
- 企业内部二开、知识库接入、模型部署调试、定时任务与远程控制。
- Cherry Studio、DeepSeek Harness 和 DeepChat 的不同产品取向。
- Sandbox、Electron、多 Agent 并发和核心拆分之间的取舍。
- MCP 2.0、Code Mode 与 ACP 作为 Agent 扩展方式的可能性。
- 为什么 DeepChat 希望成为开源社区的 AI 前沿技术试验田。
- 如何根据任务选择模型:速度、价格和完成质量都要算进去。
- 两位开发者怎样安排夜间任务、自动 Review、CI 和发布。
- AI 让 PR 更容易生成之后,开源维护者面对的新负担。
时间轴
(时间轴对应本期最终处理音频,总时长约 01:10:30。)
- 00:00 开场:DeepChat、两位嘉宾与倒置鲸鱼 Logo
- 00:29 嘉宾介绍:杨老师、灰灰与各自负责的方向
- 01:32 为什么从头做一个开源桌面 AI 客户端
- 02:53 杨老师的开源起点:文档、翻译、小工具与零散 PR
- 06:14 灰灰从实习需求到核心维护者的开源路径
- 10:11 从搜索型 Chatbot 到 Agent:DeepChat 的演进
- 12:36 模型适配、流式 Markdown 与渲染层拆分
- 14:34 Tape 与 Harness:把上下文处理经验组织成系统
- 17:17 Memory 在科研、对话、项目管理和代码重构中的不同用法
- 20:19 企业二开、知识库、模型调试与定时任务
- 24:33 Cherry Studio、DeepSeek Harness 与 DeepChat 的定位差异
- 31:35 Sandbox、Electron、并发性能与核心拆分
- 37:16 MCP 2.0、Code Mode 与外部 Agent 接入
- 40:55 DeepChat 的长期方向:开源社区的 AI 试验田
- 47:02 为什么应该按任务选择模型
- 56:16 两位开发者的 Agent 工作日:晚上布置任务,早上收结果
- 58:29 把代码 Review 放进能真正运行项目的机器
- 01:00:37 同一句 Prompt 打三次,就考虑做成 Skill 或自动化
- 01:03:25 提 PR 的勇气与合 PR 的维护成本
- 01:06:01 Beta、终端工具与“作者自己也要持续使用项目”
- 01:09:36 结尾:欢迎贡献,但先理解你提交的代码
本期嘉宾
夕阳针:DeepChat 最早的开发者之一,持续参与项目维护与 Agent 方向的实践。
小灰灰:DeepChat 核心维护者,参与 Tape、上下文管理、Memory 等方向的工作。
主持人:Asta。
适合谁听
- 正在做 AI 客户端、Agent 或开发者工具的人。
- 想理解 Harness、上下文管理、Memory、Sandbox、MCP 和 ACP 的开发者。
- 想从真实项目里学习桌面端、模型适配与开源协作的人。
- 正在尝试把 Agent 放进代码 Review、CI、部署和日常工作的团队。
- 想开始参与开源,却还不知道从哪里迈出第一步的人。
听完可以带走的几个判断
1. Agent 的体验不只取决于模型,还取决于上下文、工具、运行环境和可验证的执行过程。
2. Memory 没有脱离任务的“越多越好”;先确定要帮助哪一种工作,再决定保留什么。
3. 桌面端、沙箱和远程运行各有边界,性能、隐私和控制能力需要一起权衡。
4. 不同任务应该选择不同模型。复杂推理之外,速度、价格和等待时间同样影响结果。
5. 自动化可以从重复劳动开始:同一句 Prompt 重复三次,就值得沉淀成 Skill、定时任务或事件触发流程。
6. AI 生成代码降低了贡献门槛,也放大了维护成本;提交 PR 前,先理解问题、跑通改动并说明自己做了什么。
相关链接
- DeepChat 开源仓库:github.com
- DeepChat 中文 README:github.com
- DeepChat 下载:deepchatai.cn
评论区聊聊
你最近一次把重复工作交给 Agent,是什么场景?有没有一句已经输入过很多次、值得做成 Skill 的 Prompt?如果你参与过开源,也欢迎分享一次“从小问题开始贡献”的经历。