

 566
 2
这期源于听友提问:Agent应用场景越来越多,token消耗也越来越大,想听听"怎么又省钱又省 token?"
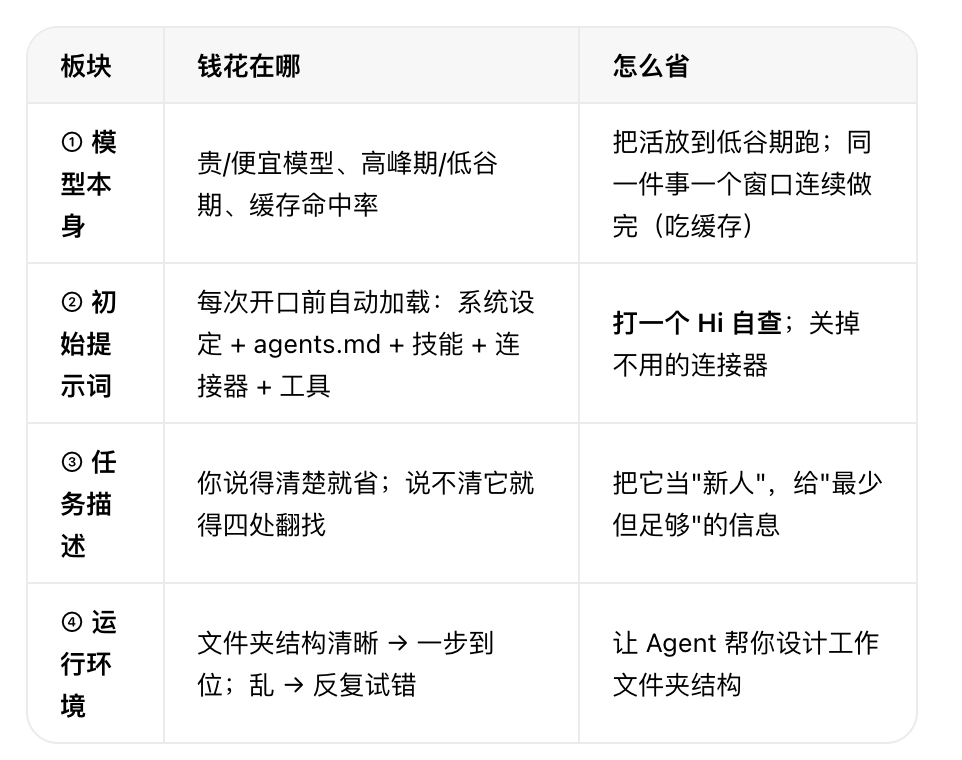
这期我们把"Agent干一次活"的成本拆成四块,一块一块讲怎么省,一张表总结:
⏳ 时间轴
【第一幕:钱都去哪了】
00:00 听友提问——应用场景变多、token 消耗变大,怎么又省钱又省 token?
【第二幕:成本四块(一)· 模型本身】
00:52 💡 理科生把"AI 干一次活"的成本分成四块(先说明:可能别人不这么分)
01:01 第一块:模型本身——用贵的还是便宜的、高峰期还是低谷期、缓存命中了多少
01:13 例:智谱下午 2–6 点是高峰期,价格是其他时间的 2–3 倍;DeepSeek 缓存价只要正常价的 2%,命中率 99%+
01:32 💡 解释"命中缓存":像一个没算过的小盒子,先把结果放进去,下次直接拿
02:29 原理:KV Cache——前面算过的结果存下来,只算新加的那部分
03:27 社科生补充:WorkBuddy 里混元模型夜间 11 点到早 8 点免费,白天积分掉得快
【第三幕:成本四块(二)· 初始提示词 ← 本期重点】
04:10 🌟 第二块:初始提示词——模型每次开口前,都要先读一大段
04:20 这一大段包括:系统提示词("你是桌面办公助手")、agents.md、Skill、MCP、Tool、专家团,全部打包在你的第一句话前面
05:07 💡 Skill 有个"渐进式披露"原则:平时只加载一段很短的描述,真正用到时才去读完整的
06:42 什么是 agents.md:记录你给它的角色定义("你是算法工程师")、以及平时去哪找文件
07:34 💡 建议:agents.md 只存"索引"(发现 A 问题 → 去找 A 文档),别把文档内容全塞进去
【第四幕:成本四块(三)(四)· 任务与环境】
08:50 第三块:你交代的任务本身——说清楚就省,说不清它就到处翻文档
09:30 💡 反直觉:模型再聪明,你不说清楚,它还是会白白浪费 token 去"猜"
10:19 第四块:运行环境——文件夹结构清晰,它一上来就知道要干什么
11:43 环境越干净越省:写代码常见做法是加代码索引工具、把命令写清楚,它就不用反复试错
【第五幕:怎么省 · 模型与初始提示词】
12:29 💡 模型:很多工具有"定时任务/闲时任务",把活放到夜间低谷期跑更便宜
13:04 💡 同一件事,尽量在一个窗口里连续做完——前面的对话算过了就不用重算(吃缓存)
14:28 缓存是有寿命的:大部分只有几分钟,久一点可能一两天(备注:GPT 5.6 说缓存保存时长至少 30 分钟,Deepseek说是几个小时-几天 )
15:20 现实困境:WorkBuddy 这类工具看不到"缓存命中率",你最后只能看到一个冷冰冰的"扣了多少积分"
17:36 💡 上下文太长要"压缩":今天 80 万、明天又是 80 万,还不如一天之内连续聊到 90 万(全是缓存价)
19:24 🌟 打一个"Hi"自查:理科生实测占了 35K;对混元 3 这种短上下文模型,这一个 Hi 就占了 20%
20:33 🌟 早期踩坑:配了一个连接器,一上来占近 8 万(当时总上下文才 12 万,占 70%),而只说了一个 Hi
21:15 MCP(连接器)比 Skill 更早期,没有"渐进式披露",整套描述都会塞进来
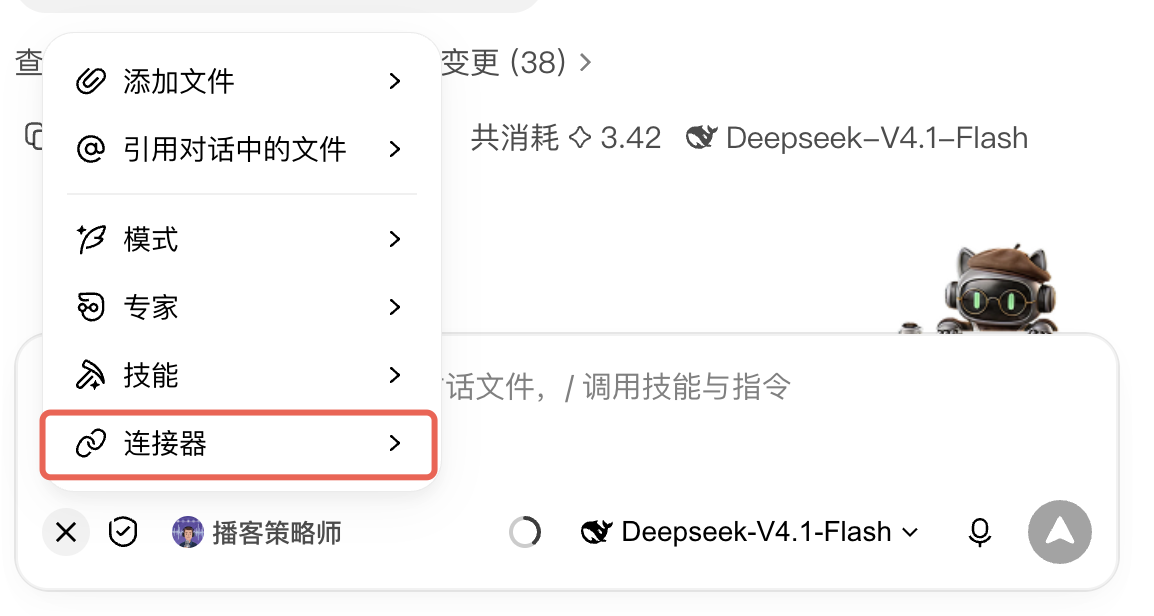
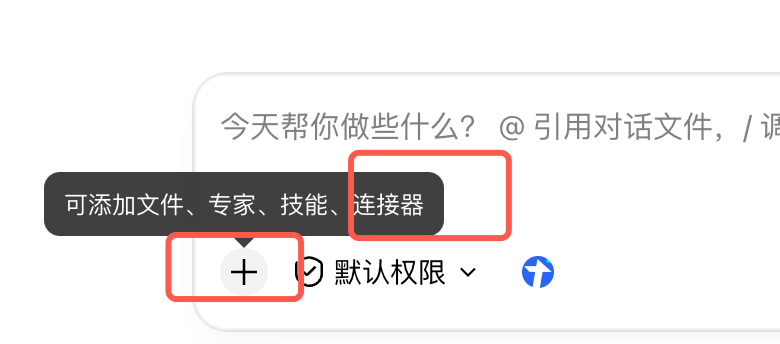
21:30 社科生发现的坑:一个窗口开过的连接器,之后每个新窗口都默认开着 → 打法:打一个 Hi 看占用 / 直接让它自查用了多少 / 手动在左下角"加号"里关掉
【第六幕:怎么省 · 任务与环境 + 两个洞察】
23:40 任务描述:把 AI 当"新人"看,给它"最少但足够"的信息,别把它当"许愿机"
24:20 运行环境:可以让 Agent 帮你设计工作文件夹的结构,往往比你自己想更清晰
25:48 💡 洞察:模型一直在降价,但你的账单更贵了——因为你让它干的活越来越多、越来越复杂
26:07 💡 洞察:贵的模型做规划和验收,便宜的做执行("顶尖模型像导师,中间执行交给牛马模型")
【第七幕:买哪家 + 最小行动】
26:51 买哪家:价格变化太快,这期只聊机制——Coding Plan(编程套餐)/ 积分制 / 海外套餐
28:30 分情况建议:新手用 WorkBuddy(送积分);用量大上 Coding Plan(从 Lite 档起);用量很大考虑 Max(单价最低)
28:53 📋 最小行动(新手):下载 WorkBuddy,用免费积分试水,感受不同模型/费率/耗量
29:49 📋 最小行动(老手):买 Coding Plan(GPT Plus 20 美金/月;国内智谱、Kimi 等);写代码的还可以看 OpenCode(内置免费额度模型)
30:43 收尾:欢迎评论、收藏、转发,加入听友群
━━━━━━━━━━━━━━━━━━━━━━
📋 最小行动
如果你是新手|下载 WorkBuddy,用它免费送的积分先试手——它是目前少数能同时用 Kimi、混元、DeepSeek、GLM 多家模型的工具,你可以直接感受"不同模型 = 不同费率"
如果你已经用了一段时间|打一个"Hi",看它上下文占了多少;超了就把不用的连接器关掉
如果你觉得 token 不够用|考虑买 Coding Plan(国内智谱/Kimi 等;海外 GPT Plus 20 美金/月)
用量很大、又要在意性价比 → 直接上Coding Plan Max 档,虽然总价最高,但单价一定最低
━━━━━━━━━━━━━━━━━━━━━━
💬 本期金句
· 「我原来以为省钱的办法就是换一个更便宜的模型,聊完这期前采才发现,还有很多别的因素。」
· 「你只打了一个 Hi,它已经把系统提示词、你的角色定义、你装过的所有技能和连接器,全部先读了一遍。」
· 「打一个 Hi,占了 35K。」
· 「配了一个连接器,一上来就占了接近 8 万的上下文——当时总共才 12 万,等于只说了一个 Hi,就被占掉了 70%。」
· 「把它当一个新人看待,给它最少但足够的信息;不要把它当许愿机。」
· 「顶尖的模型像导师,负责把关方向;中间的执行,交给牛马模型。」
· 「模型一直在降价,但你的账单更贵了——因为你让它干的活,越来越多、越来越复杂。」
━━━━━━━━━━━━━━━━━━━━━━
🔧 本期提到的工具 / 概念
· token —— 你可以理解成"字数",AI 计费的基本单位
· 缓存命中(KV Cache) —— 前面算过的结果存下来、下次直接取,价格极低;同一窗口连续对话才能吃上
· 初始提示词 —— 每次开口前自动加载的一整段:系统设定 + agents.md + 技能 + 连接器 + 工具
· agents.md —— 你写给 AI 的"角色定义 + 文件索引"文档
· Skill / 技能 —— 有"渐进式披露":平时只加载短描述
· MCP / 连接器 —— 没有渐进式披露,装上就整套占上下文,不用建议关掉
· Coding Plan ——编程/使用套餐(订阅制)
· WorkBuddy / 千问办公 / OpenCode /豆包办公 —— 本期提到的几类工具形态(积分制 / 内置免费额度)
· WorkBuddy —— 和千问办公与豆包办公对比,Workbuddy可以调用多家国内模型(*更正:Workbuddy不是市场上唯一可以调用多家模型的agent工具。听友用的Easyclaw也可以调用多家模型,它的国际版还可以调多家海外模型,谢谢Kevin 反馈)
· WorkBuddy打开/关闭连接器入口如图:
━━━━━━━━━━━━━━━━━━━━━━
🧍♂️ 联系我们
微信听友群:加 13826477686 微信进群(加微信时辛苦备注"AI搞学术"或"小宇宙")
听众反馈:514634244@qq.com