
 47
 0
本简报对 Claude Code 中新增的 Effort(思考投入度) 机制进行了深度分析与总结。Effort 是用于控制模型在任务上消耗计算资源(Compute)与时间近似值的机制。研究与基准测试表明,提升 Effort 能显著增强模型的自主决策能力、边角情况(Edge Cases)测试以及自主验证能力,从而有效提高复杂任务的成功率;而低至中等 Effort 则能够提供快速反馈,非常适合人机协同(In-the-loop)的迭代开发。
针对不同类型的任务(从日常软件工程到高难度的安全、硬件及科学计算任务),合理调整 Effort 层级(Low、Medium、High、Max/XHigh)能够在开发效率与输出质量之间取得最佳平衡。
一、 Effort 的概念与核心原理
1. 什么是 Effort?
计算资源与时间的近似度量:Effort 给模型提供了一个大致的参考,指示其在特定任务上应当消耗多少计算量(Compute)。这与人工对任务难度的建模方式类似(例如:要求在 12 小时内完成与 1 小时内完成,工作的深入程度与迭代方式会有显著差异)。
自主性与验证力度的体现:高 Effort 不仅意味着消耗更多 Token,更代表 Claude 会采取更多独立的行动来进行自主判断、自我审查与验证。
Prompt Cache 兼容性:在 Claude Code 中调整 Effort 水平不会破坏 Prompt Cache(提示词缓存),保证了高效的交互性能。
2. Effort 曲线与能力表现
在 Fable 5.1 与 Opus 5.5 模型中,Effort 曲线表现出显著的效果:随着 Effort 级别的提升,基准测试得分(如 Terminal Bench 3.0)与消耗的 Token 量同步增长。
提升显著的领域:在需要大量验证和边角情况测试的领域(如硬件设计、代码审查、性能优化和安全审计),高 Effort 带来的改善最为明显。
局限性:增加 Effort 能够大幅减少因**遗漏边角情况(Missing Edgecases)而导致的失败,但无法修复模型初始解题方向错误(Wrong Approach)**的问题。
二、 不同 Effort 层级在开发任务中的实践表现
通过在 Opus 5.5 上对不同复杂度的任务进行对比测试,Effort 展现出以下具体影响:
1. 规格不明确的构建任务(Underspecified build task)
示例:要求 Claude“构建一个个人健身与运动追踪应用”。
低 Effort:生成一个仅包含基本日志和简单图表的基础应用,适合作为快速迭代的初始框架。
高/最大 Effort:生成功能更复杂、细节更丰富的应用;在最大 Effort 下,甚至会自主添加热度图(Heat chart)。
2. 规格较轻度的设计任务(Lightly specified design task)
示例:重新设计 Claude Code 中的
/config菜单。低 Effort(耗时约 1 分钟):快速输出一个交互式草图,直观表达核心概念(如子菜单和搜索功能),但视觉上不太像 Claude Code。
最大 Effort(耗时约 28 分钟):输出高度精致、极具 Claude Code 原生风格的高保真原型,并附带针对不同交互流程的完整演练说明。
3. 规格高度明确的构建任务(Highly specified build task)
示例:先对需求进行深度访谈并生成详细规格书(Spec),再交由模型执行。
表现:在给定详尽 Spec 的情况下,不同 Effort 层级生成的代码结构和设计非常相似。但在最大 Effort 下,Claude 会花费额外时间对部分细节进行精简和优化。
三、 复杂任务与基准测试(Terminal Bench 3.0)深度分析
Terminal Bench 3.0 是一个社区驱动的基准测试,涵盖安全、硬件、机器学习、科学、软件、运维和媒体等高难度领域。在该测试集上的对比进一步揭示了高 Effort 的核心价值。
1. 高难度任务类型示例
硬件 (retro-console-soc):用 Verilog 编写一个适配小型 FPGA 的 8 位游戏主机,并运行测试 ROM。
科学 (takens-embedding-lean):在 Lean 4 中形式化证明 Takens 嵌入定理。
机器学习 (mp-checkpoint-consolidation):将专家混合(MoE)检查点的 16 个分片合并为一个能够复现参考 logits 的文件。
运维 (intrastat-meldung):端到端运行一家公司月末的欧盟贸易统计申报。
媒体 (layout-config-recreation):将海报图像重建为可编辑的布局文件。
2. 高 Effort 应对复杂边角情况的具体案例
任务名称与领域
模型与 Effort 级别变更
低 Effort 表现
高 / 超高 Effort 表现
html-js-filter
(安全:HTML 清洁器)
Fable 5.1
1/5 (Low) $\rightarrow$ 5/5 (XHigh)
耗时约 2 分钟。单次生成过滤代码,仅针对单个手写页面进行简单测试。
耗时约 33 分钟。对初稿进行对抗性审查,阅读已安装解析器的源码以排查 Bug,运行标准 XSS 测试集,并编写随机文档模糊测试器(Fuzzer)。
mvcc-lsm-compaction
(存储引擎 Bug 修复)
Opus 5.5
0/5 (Low) $\rightarrow$ 4/5 (XHigh)
耗时约 1 分钟。在构建或运行复现脚本前就直接修改代码,未验证新测试是否能捕捉原始 Bug。
耗时约 11 分钟。先复现崩溃问题,编写针对不合并参考系统的随机测试,并确认其测试能准确捕获未完成修复的代码缺陷。
cli-2ph-simple
(线性规划求解器)
Opus 5.5
0/5 (Low) $\rightarrow$ 5/5 (High)
单次编写求解器,仅用少量简单问题测试,Token 消耗约 10k 即停止,未对大规模问题进行性能验证。
将求解器与独立的暴力求解器进行随机问题对比测试,对大规模问题计时,遇到超时或崩溃时主动重构搜索算法。
gsea-proteomics
(蛋白质组学数据分析)
Opus 5.5
0/5 (Low) $\rightarrow$ 4/5 (High)
选择一种看似合理的方法预处理数据,运行一次分析即报告结果。
尝试了两种数据预处理方法,注意到显著治疗列表发生变化后深度排查原因,最终选择正确的方法。
四、 Effort 层级的选择策略与最佳实践流程
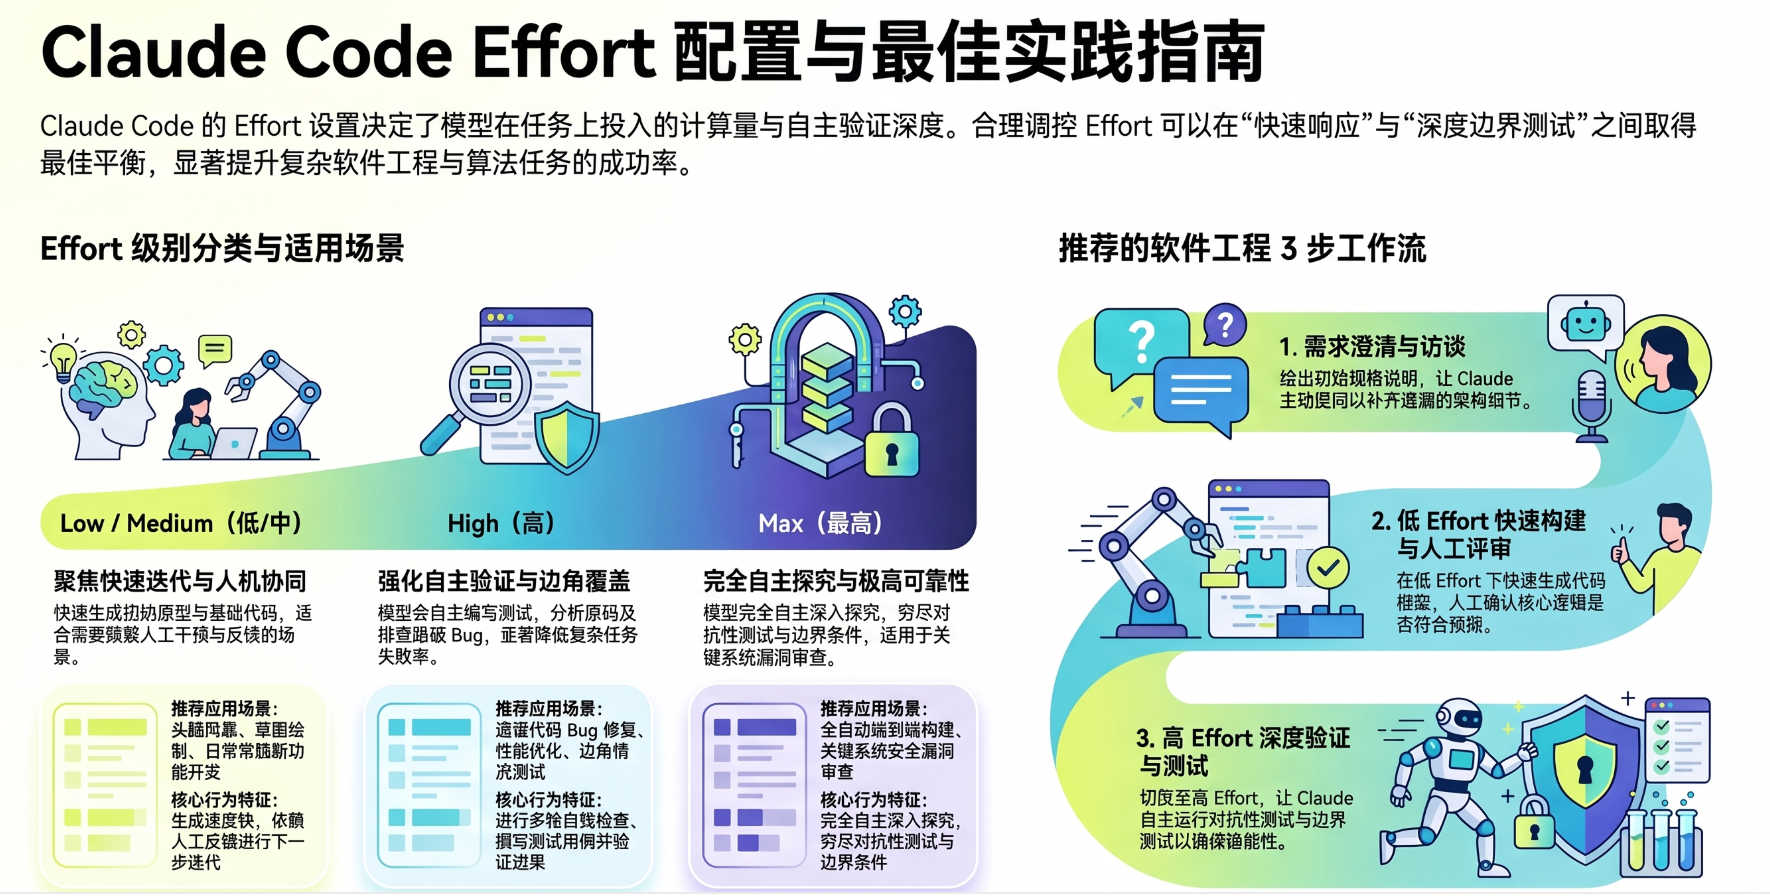
1. Effort 层级使用法则(Rule of Thumb)
Low(低):用于需要快速响应且保持人机协同的场景,如脑暴(Brainstorming)、概念草图绘制(Sketching)、简单变更。
Medium(中):适用于大部分日常软件工程任务,如新功能实现(New feature implementation)。
High(高):用于验证至关重要或存在大量潜在边角情况的场景,如在遗留/老旧代码库(Brownfield codebase)中修复 Bug。
Max / XHigh(最大/超高):用于需要 Claude 全自主运行以解决极高难度问题的场景,如端到端的应用构建与验证、关键软件的安全性漏洞挖掘。
2. 软件功能开发的最佳循环流程(Recommended Iterative Loop)
为了兼顾开发效率与代码质量,建议采用以下四步开发循环:
[1. 需求访谈] ──> 给定初始 Spec,让 Claude 采访自己以补全遗漏细节 │ ▼[2. 低度构建] ──> 使用 Low / Medium Effort 进行初步代码实现 │ ▼[3. 人工审查] ──> 检查核心逻辑是否正确,必要时在 Low Effort 下继续迭代 │ ▼[4. 高度验证] ──> 切换至 High / Max Effort 进行全面的测试与深度验证3. 操作方式
在使用 Claude Code 时,用户可以通过输入命令 /effort 在会话过程中或针对特定任务随时调整 Effort 层级。
thumb_up报告内容不错 thumb_down报告内容不好
