
 45
 0
【赞助商】
OpenClaw快报
每天五分钟,听听 OpenClaw 快报,带你了解最新动态和业内讨论
传送门 www.xiaoyuzhoufm.com
【目录】
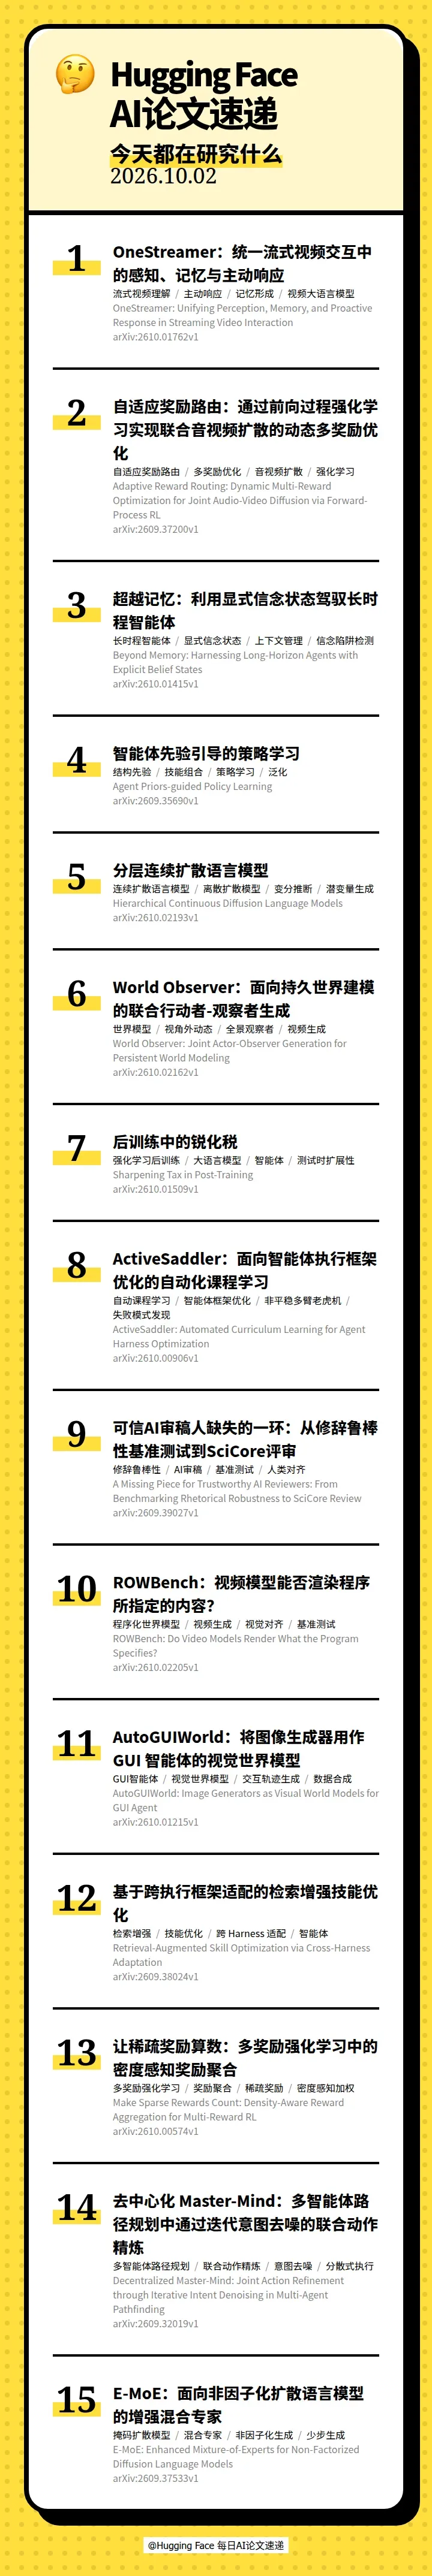
本期的 15 篇论文如下:
00:29 🎥 OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction(OneStreamer:统一流式视频交互中的感知、记忆与主动响应)
01:11 🔀 Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL(自适应奖励路由:通过前向过程强化学习实现联合音视频扩散的动态多奖励优化)
01:55 🧠 Beyond Memory: Harnessing Long-Horizon Agents with Explicit Belief States(超越记忆:利用显式信念状态驾驭长时程智能体)
02:38 🤖 Agent Priors-guided Policy Learning(智能体先验引导的策略学习)
03:25 🌀 Hierarchical Continuous Diffusion Language Models(分层连续扩散语言模型)
04:03 👁 World Observer: Joint Actor-Observer Generation for Persistent World Modeling(World Observer:面向持久世界建模的联合行动者-观察者生成)
04:54 📉 Sharpening Tax in Post-Training(后训练中的锐化税)
05:39 🎯 ActiveSaddler: Automated Curriculum Learning for Agent Harness Optimization(ActiveSaddler:面向智能体执行框架优化的自动化课程学习)
06:22 🤖 A Missing Piece for Trustworthy AI Reviewers: From Benchmarking Rhetorical Robustness to SciCore Review(可信AI审稿人缺失的一环:从修辞鲁棒性基准测试到SciCore评审)
07:08 🎮 ROWBench: Do Video Models Render What the Program Specifies?(ROWBench:视频模型能否渲染程序所指定的内容?)
07:55 🤖 AutoGUIWorld: Image Generators as Visual World Models for GUI Agent(AutoGUIWorld:将图像生成器用作 GUI 智能体的视觉世界模型)
08:39 🔍 Retrieval-Augmented Skill Optimization via Cross-Harness Adaptation(基于跨执行框架适配的检索增强技能优化)
09:23 ⚖ Make Sparse Rewards Count: Density-Aware Reward Aggregation for Multi-Reward RL(让稀疏奖励算数:多奖励强化学习中的密度感知奖励聚合)
10:05 🤖 Decentralized Master-Mind: Joint Action Refinement through Iterative Intent Denoising in Multi-Agent Pathfinding(去中心化 Master-Mind:多智能体路径规划中通过迭代意图去噪的联合动作精炼)
11:02 🧩 E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models(E-MoE:面向非因子化扩散语言模型的增强混合专家)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
