
 33
 0
💡 今日思考
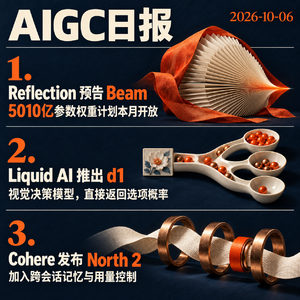
看到d1这样的决策模型,我觉得创作者可以重新检查自己的工作流:哪些步骤真的需要AI写一大段话?选出合适的配图、判断资料是否相关、检查内容是否缺项,很多时候只需要一个选择和足够可信的依据。让模型自由发挥,反而可能增加后续解释与核对的工作。不过,是否值得换工具,还得把漏判、误判和人工复核的时间一起算进去,低价本身不能证明省事。
另一件值得留意的事,是工具开始同时影响内容的来源判断和商业展示。textGrain仍有检测局限,ChatGPT的新广告也还处于计划测试阶段。分享这些消息时,最好让读者清楚知道:现在能用什么,谁能用,哪些事情还没有发生。尤其不能拿一个水印检测结果,就给作者的创作过程下结论。
对我来说,开源模型和创作工具真正值得持续关注的地方,是能否留下可检查、可修改的成果。Beam后续发布的权重与工具是否齐全,North 2的记忆能否帮助完成跨会话任务,都值得在开放后用同一份真实工作验证。今天的公告提供了试用线索,最终判断仍要落在自己的任务上。
