
 9
 0
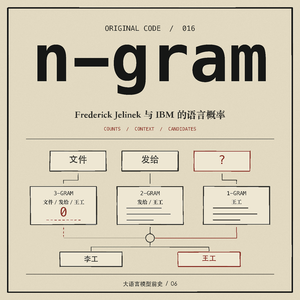
一句“请把文件发给王工”,每个词都见过,机器为什么仍可能把它挡在候选之外?本期《原代码》从 Frederick Jelinek 与 IBM 团队的语音识别研究出发,追踪三词统计、插值与独立检验,再把同一句话放进近期 ASR 的声音编码、语言解码与流式处理,比较经验怎样成为一次新的判断。
从一封想交给机器的信,到一个仍应获得机会的新组合:程序留下了哪个候选,我们又怎样检查它所依据的声音、记录和上下文?
你可在官方网站 yuandaima.xyz 中查看本期逐字稿、证据引用关系和证据快照。
时间轴
00:00 先念一封信
02:17 一段声音,两份依据
04:37 每个词都见过,这句话却没有
07:19 给王工留一个位置
09:57 让新文字检验改动
13:47 近处之外,还有线索
16:11 同一句话,换一套识别机器
25:15 回到这封信
本期资料
- [Frederick Jelinek:The Dawn of Statistical ASR and MT(2009,ACL 获奖演讲文本)](aclanthology.org)
- [Frederick Jelinek、Lalit R. Bahl、Robert L. Mercer:Design of a Linguistic Statistical Decoder for the Recognition of Continuous Speech(1975,IBM 官方摘要)](research.ibm.com)
- [IBM 团队:Experiments with the Tangora 20,000 Word Speech Recognizer(1986,官方摘要)](research.ibm.com)
- [Peter F. Brown 等:Class-Based n-gram Models of Natural Language(1992)](aclanthology.org)
- [NIST:DARPA Resource Management Benchmark Test Results June 1990(1990)](aclanthology.org)
- [Ciprian Chelba、Frederick Jelinek:Exploiting Syntactic Structure for Language Modeling(1998)](aclanthology.org)
- [Yoshua Bengio 等:A Neural Probabilistic Language Model(2003)](jmlr.org)
- [Alec Radford 等:Improving Language Understanding by Generative Pre-Training(2018,后来称为 GPT-1)](cdn.openai.com)
- [Qwen-Audio ASR Team:Qwen-Audio-3.0-ASR Technical Report(2026,v2)](arxiv.org)
- [Mistral AI:Voxtral Realtime(2026,v3)](arxiv.org)
说明与延伸阅读
- 本期讲述的是 IBM 团队怎样把语言概率接入识别系统。Lalit R. Bahl、Robert L. Mercer、Peter F. Brown 等各有贡献;Jelinek 的 2009 年材料是参与者后见回忆。本期采用旁白讲述,获奖演讲文本不等于剪入了他的历史录音。
- 四条中文记录、“文件、发给、王工”及后面的提示 / 改口情境,都是节目构造的机制说明,使用固定分词和说明用分量。它们不是 IBM 的历史实验或近期模型实测;给王工非零概率,只让候选重新参加比较,声音与搜索仍须支持最后的识别。
- 困惑度比较语言模型给测试文本分配的概率,识别错误率评价整套系统写对了多少词。两项指标的对象不同;NIST 的 Resource Management 横评也不是 Tangora 的同一场测试,成绩需要连同任务、训练条件和评分办法理解。
- Bengio 等人在 2003 年论文中明确讨论 Jelinek–Mercer 插值。后来的神经语言模型延续条件预测问题,改变词表示和概率函数;共同目标不意味着 n-gram、感知机与 GPT 使用同一种结构,也不建立一条唯一的个人传承链。
- 两万词形成的约八万亿三词组合,是完整概率空间,不能与 Voxtral 报告中约 44 亿网络权重直接比倍数。70 亿指 Fun-ASR 前代文字解码器,Qwen-Audio-3.0-ASR 的精确总 / 激活参数未在所用报告中公布;约两千万小时则是其音文预训练阶段的作者披露数据量,不是词表或参数数量。
- 近期 ASR 比较固定使用 Qwen-Audio-3.0-ASR 报告 v2 与 Voxtral Realtime 报告 v3,机制、数据和能力说明来自作者公开材料,没有独立复跑或作全行业排行榜。可选润色文本与逐字转录各有用途;核对引语仍需回到原声,保留当时的重复与改口。
