
 12
 0
1. 导言:被忽视的AI终极瓶颈(Introduction: The Hidden Bottleneck of AI)
当今科技界正陷入一场前所未有的 AI 算力与内存狂热。从昂贵的高带宽内存(HBM)到供不应求的旗舰 GPU,各大云巨头正在将数以千亿计的资金砸向计算核心。然而,当单体芯片的物理性能逼近极限,全行业必须面对一个颠覆性的反问:如果算力不再是唯一的制约因素,真正限制 AI 基础设施演进的究竟是什么?
答案隐藏在数据流动的物理世界中。在刚刚落幕的 Marvell 2026 投资者日(Investor Day 2026)上,这家半导体巨头给出了极其明确的判断:数据流动与网络连接(Connectivity)已成为 AI 集群演进的最大物理瓶颈。
从数据中心之间的千米跨越,到机架内部的厘米级传输,乃至芯片封装内的毫米级互连,数据的传输效率正直接决定着庞大 GPU 集群的产出效率。本文将深度拆解 Marvell 在战略发布会中披露的最具冲击力、反常识的 6 大核心洞察,带你把脉未来 5 至 10 年半导体与云计算基础设施的底层演进逻辑。
2. 洞察一:算力狂欢后的下一个超级风口——为什么“数据连接”决定AI成败?(Connectivity as the Next Defining Unlock)
AI 基础设施的演变可清晰地划分为三个主导阶段:算力芯片(Compute) -> 内存芯片(Memory) -> 连接技术(Connectivity)。
在 AI 浪潮开启之初,市场价值高度集中于计算芯片巨头;随后,随着模型参数暴涨,内存带宽不足引发“内存墙”,三大内存巨头迎来高光时刻。而如今,随着 AI 集群规模跨越数万颗节点,系统已经全面撞上“数据传输墙”。我们正正式跨入**“连接即解锁(Connectivity Unlock)”**的全新阶段。
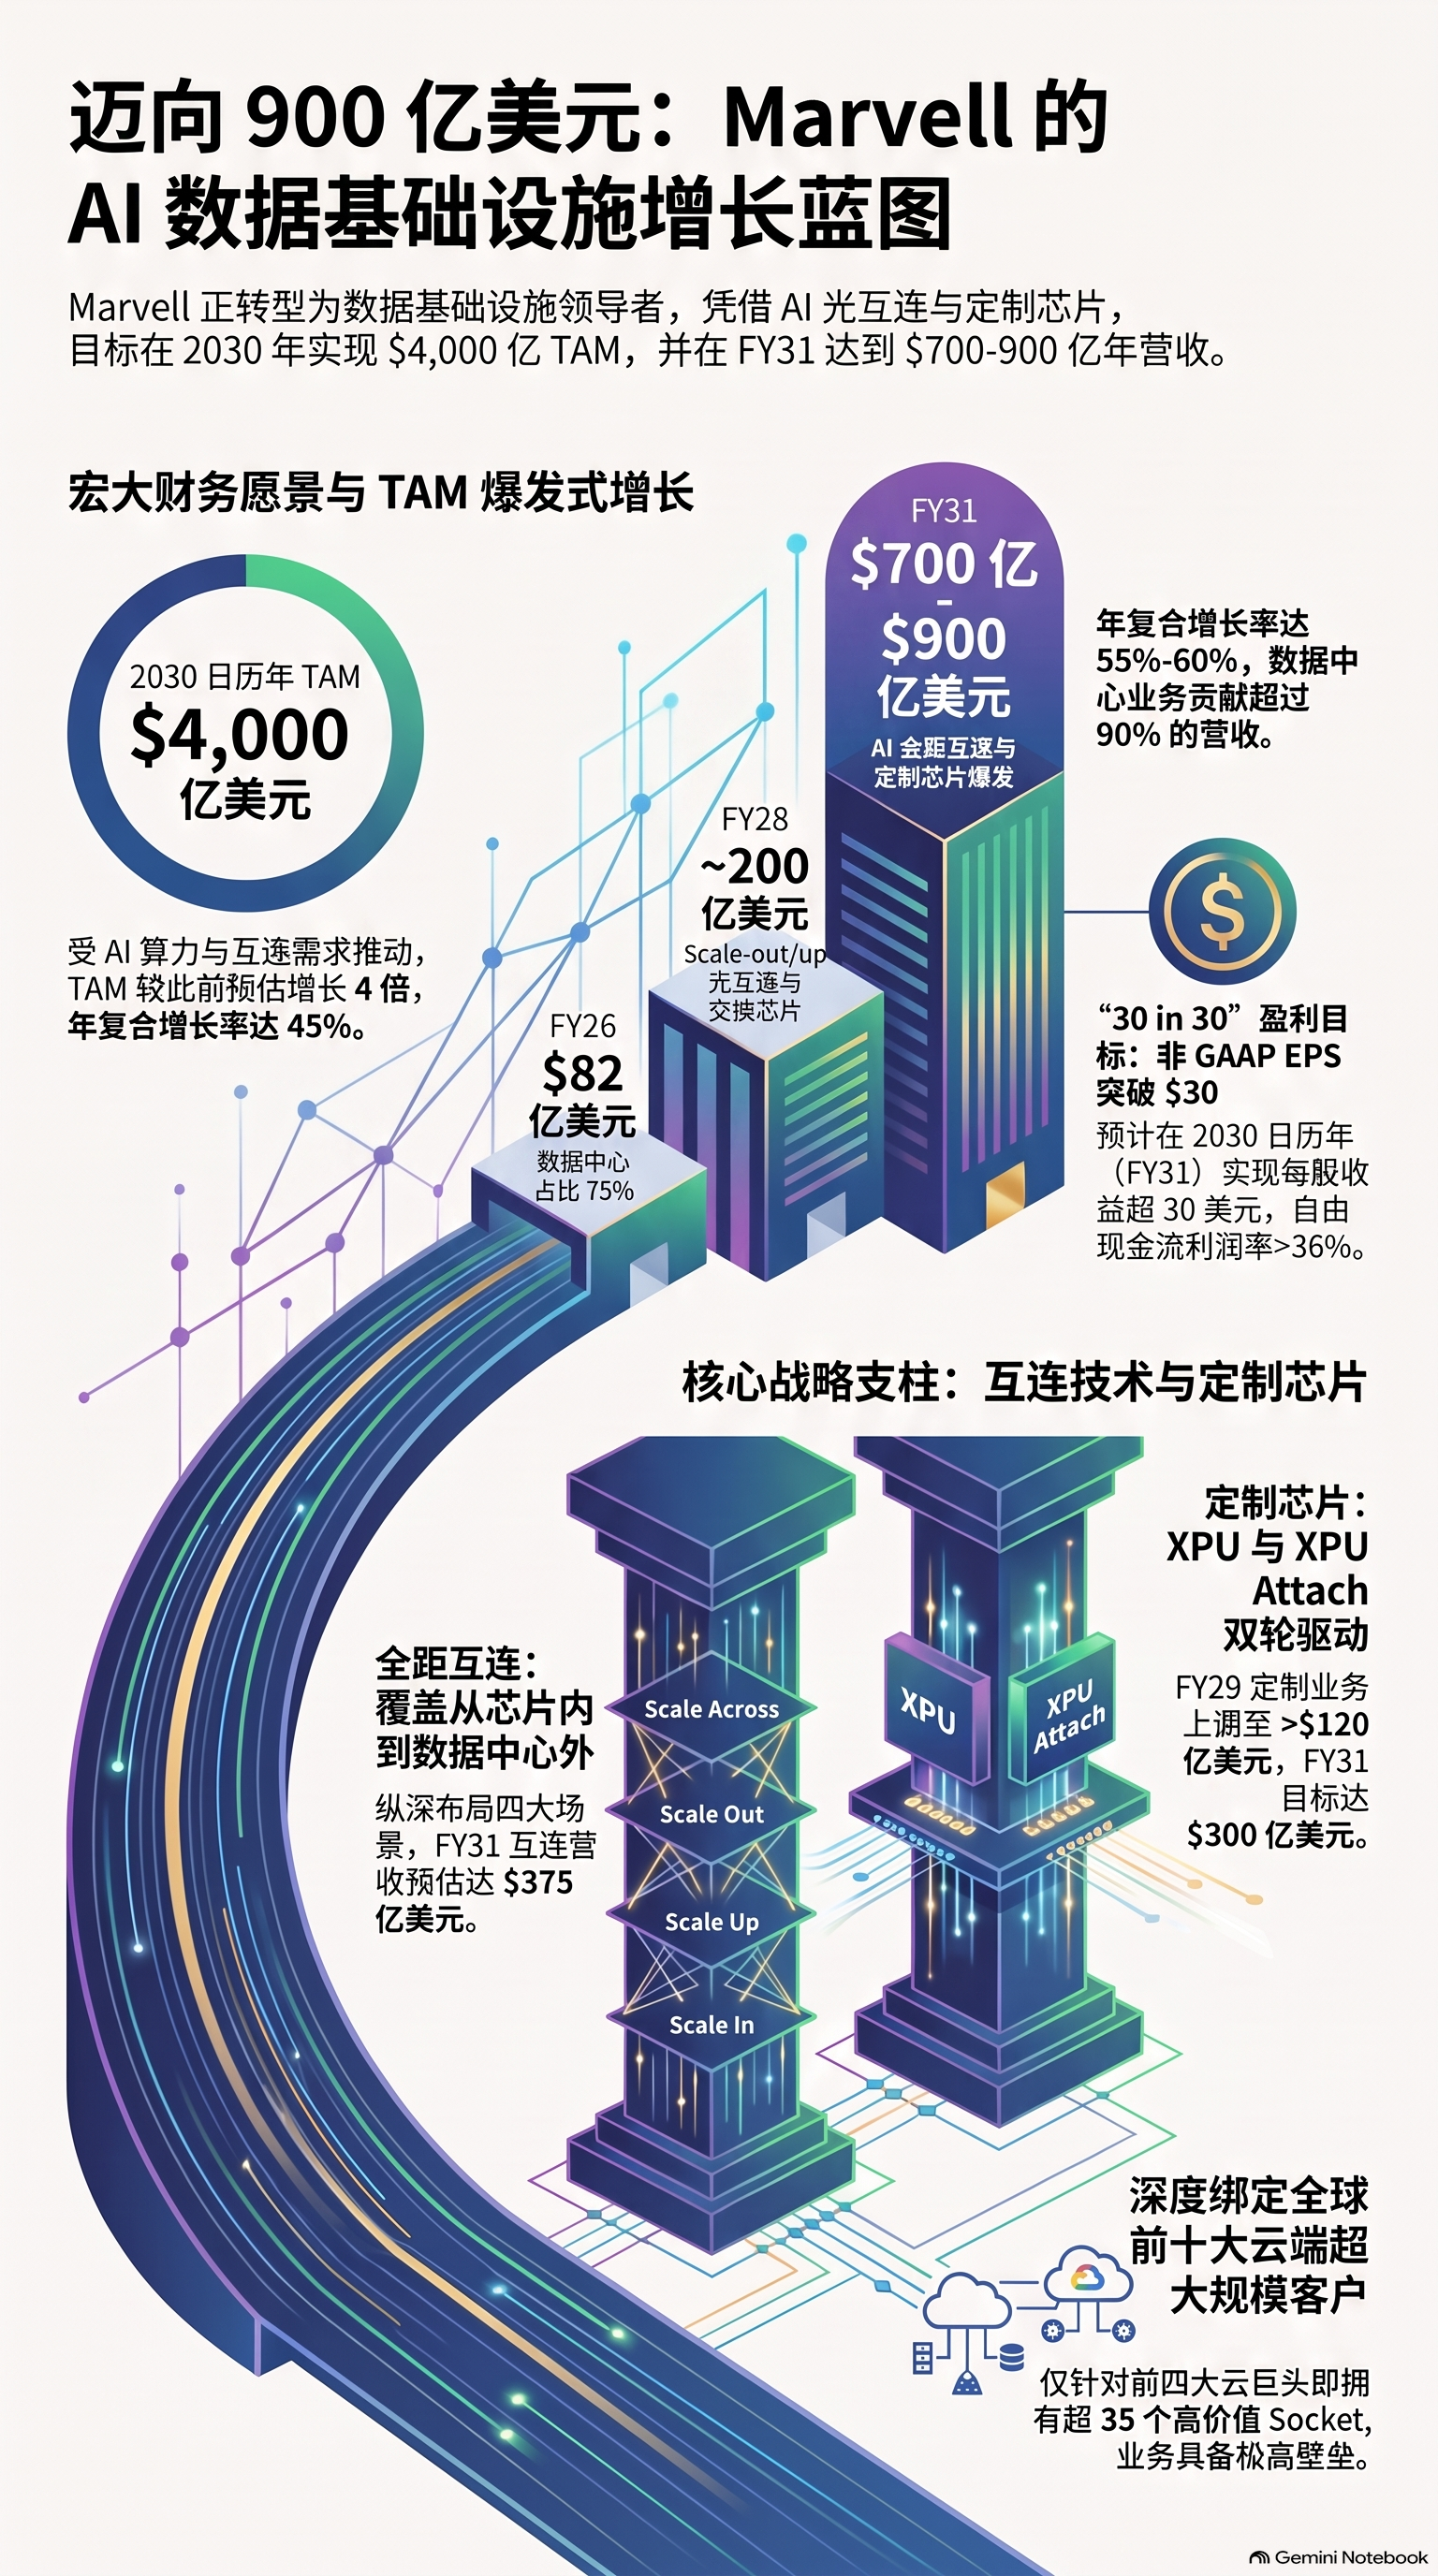
在 FY26(2026 财年),Marvell 实现了 82 亿美元的总营收,其中数据中心业务占比高达 75%。对收入结构进行深层拆解会发现一个颠覆常识的事实:在这笔庞大的数据中心收入中,70% 直接来自“连接”(Connectivity),仅有 30% 来自传统计算。
随着代理式 AI(Agentic AI)、推理模型(Reasoning Models)以及超大规模分布式训练的普及,数据传输的频率与流量模式发生了根本性改变。庞大的 GPU 算力如果得不到高速、低延迟网络的数据“喂养”,就会沦为无用的**“被搁浅算力(Stranded Compute)”**。
在发布会现场,当 Wall Street 分析师们习惯性地将目光聚焦于主算力芯片时,Marvell 董事长兼 CEO Matt Murphy 抛出的这番论断,彻底刷新了资本市场对半导体价值链的认知:
"As systems scale, more and more data needs to move across every distance. And Marvell is fundamentally a connectivity first company... In many ways, we're enabling the entire industry."
(“随着系统规模的扩大,越来越多的数据需要在各个距离上流动。而 Marvell 本质上是一家连接优先的公司……在许多方面,我们正在赋能整个行业。”)
3. 洞察二:十年豪赌400亿美元——从消费电子小厂到数据中心巨头的逆袭(A Decade in the Making: The $40B Platform Investment)
今日数据中心巨头的地位,源于十年前一次极其果断的战略重塑。
时针拨回 2017 年,当 Matt Murphy 刚刚接任 CEO 并在 Marvell 首届投资者日登台时,Susquehanna 分析师 Chris Roland 严肃地抛出疑问:“这到底是一家什么公司?这是 Marvell 吗?”因为彼时的 Marvell 仍被贴着“消费电子芯片厂”的标签(产品主要面向智能手机、平板等),数据中心营收占比不足 10%。
然而,Marvell 当时便确立了“数据传输、数据存储、数据处理”的核心使命。十年来,无论市场如何起伏,这句使命宣言字字未变。为了将这一愿景落地,Marvell 展开了半导体史上罕见的战略转型:累计投入约 400 亿美元构建技术平台。
约 200 亿美元精明战略并购:通过并购 Inphi、Celestial AI 等领域顶尖企业,补齐高速光互连、硅光子学等关键拼图。
约 200 亿美元有机研发(Organic R&D):在先进制程与先进制程封装上持续投入重金,作为技术演进的“火箭燃料”。
高溢价剥离非核心业务:通过剥离非数据中心资产获得高溢价资金,将全公司资源精准聚焦于云与数据中心基础设施。
Marvell 数据中心战略演进时间轴:
2018年:预判 AI 将成为数据中心核心驱动力,前瞻布局 AI 训练与推理的数据流动架构。
2020年:提出专用基础设施芯片概念,将网络、安全与存储功能从通用 CPU 中解耦。
2021年:定义“云定制芯片(Cloud Optimized Silicon)”时代,推动计算、光互连与存储的模块化定制。
2024年:确立前向与后向网络(Frontend/Backend)的光互连主导化趋势。
2025-2026年:迎来定制芯片(Custom Silicon)与 XPU Attach(XPU附加芯片) 生态的大爆发。
正如 Marvell 一位任职超过 15 年的资深 Senior Fellow 在内部工程会议上感叹:“十年前 Matt 提出这个使命时,我完全不知道他在说什么;十年后的今天,我们真正拥有了移动数据、存储数据、处理数据的所有拼图。”
4. 洞察三:物理定律不妥协——撞上“铜缆墙”与“内存墙”后的光互连革命(Overcoming Physical Walls: The Scale Up & Scale In Revolution)
AI 基础设施的演化正受到严苛物理定律的无情制约。数据中心在扩容过程中,无可避免地撞上了三大物理墙:
内存墙(Memory Wall):推理计算与 KV Cache(键值缓存)机制导致内存需求暴增,单靠 package 内部的 HBM 远不能满足容量与延迟需求。
铜缆墙(Copper Wall):当单通道速率提升至 200G/400G(per lane)时,铜缆的有效传输距离缩短至 2.5 米以内。传统的机架内(In-rack)铜缆连接被迫全面向光互连转型。
功耗与延迟墙(Power & Latency Wall):传统可插拔(Pluggable)光模块体积大、功耗高,无法满足机架内部极高密度的低延迟互连要求。
在发布现场,Sandeep Bharathi 与 Dave Lazovski 揭示了一个震动科技界的**“85/15 流量分配悖论”**:在当今 AI 数据中心的所有数据传输流量中,高达 85% 的流量集中在 Scale-Up(机架内/XPU 间扩展)领域,而传统意义上的 Scale-Out(机架间网络)仅占 15%!这意味着 Scale-Up 光互连已成为吞吐量攻坚的主战场。
为了攻克这些物理瓶颈,Marvell 提出了覆盖全距离拓扑(Scale Across / Scale Out / Scale Up / Scale In)的光电集成解法。针对 Scale-Out 场景中 500 米至 2 公里的园区级跨度,Marvell 明确指出 PAM4 调制在 400G/lane 速率下达到物理极限(有效距离限制在 500 米内),因此全面引入了 3.2T Coherent Light(相干光) 技术:
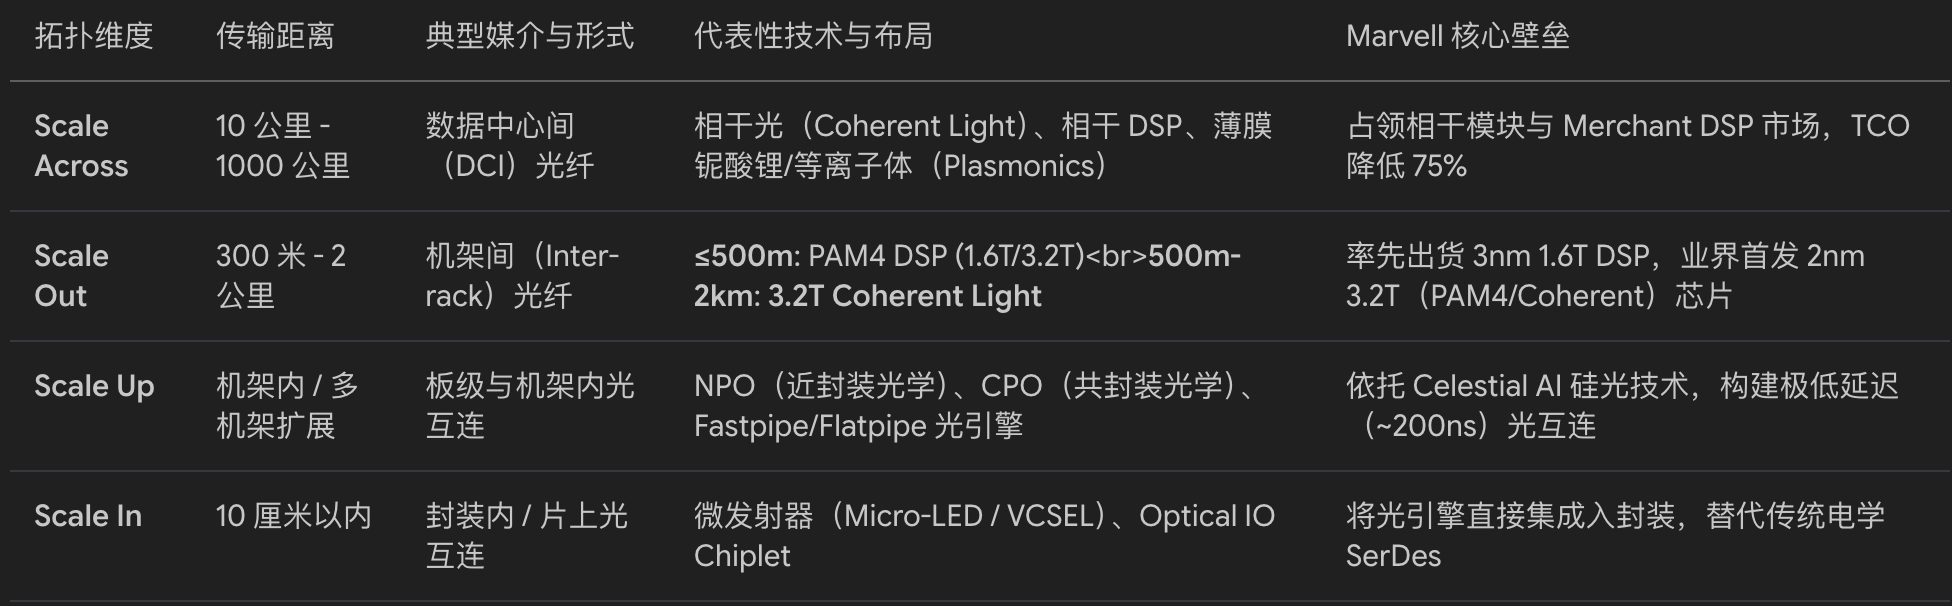
注:表中财务与技术数据对应关系涵盖 FY26-FY31(CY2025-CY2030)。
针对 Scale-Up 架构,Dave Lazovski 展示了一项重磅硬件创新——光子面料内存设备(Photonic Fabric Memory Appliance)。该设备集成了 8 至 16 个光子面料内存模块(Photonic Fabric Memory Modules),史上首次实现了高带宽内存扩展与计算核(Compute Dies)的物理解耦。
针对推理计算(Inference),Dave 详细拆解了 VLLM 等主流框架下的 KV Cache 机制:一旦 KV Cache 溢出本地内存,系统从远程节点重新加载会引发巨大延迟与“AI 幻觉”。为了让分布式 XPU 共享内存池,网络延迟必须严格控制在 200 纳秒(ns)级别。必须依靠无 DSP 设计的 Flatpipe 电路与 CPO/NPO 硅光集成技术。
Marvell 在 ECOC 2025 上展示了基于 2nm 制程的 3.2T PAM4 和 3.2T Coherent Light(单通道 400G SerDes)实机运行演示,证明其技术绝非停留在 PPT 上。
Marvell 数据中心事业部总裁 Sandeep Bharathi 在发布会上留下了这样一句金句:
"Tokenomics is just physics. Physics doesn't negotiate with strategy. The company that solves the physics problem of bandwidth, latency, reach, and power is the one that is best positioned..."
(“Token经济学本质上就是物理学。物理定律从不与商业战略谈判。谁能解决带宽、延迟、传输距离和功耗的物理难题,谁就能占据最有利的位置。”)
5. 洞察四:“XPU Attach”生态大爆发——单颗芯片外附带的千美元商业金矿(The XPU Attach Boom & Custom Silicon Expansion)
在过去的半导体商业模式中,市场高度关注“Full Custom XPU”(即全定制的 AI 主算力芯片)。但 Marvell 揭示了一个更为庞大的增量市场——XPU Attach(XPU 附加半定制芯片)。
Will Chu 与 Dave Lazovski 提出了一个极其形象的产业比喻:由于 HBM 内存被物理限制在距离 XPU 裸片 1.5 毫米 的狭窄区域内,当今的云运营商不得不将价值 30,000 美元的旗舰 GPU 当作“世界上最昂贵的内存控制器”来使用。为了摆脱这种极度低效的资源浪费,XPU Attach 市场迎来爆发。
每一颗 XPU 旁边,通常需要附带 1 到 2 个 XPU Attach 插槽(Sockets),平均单价(ASP)高达 ~$1,000 美元。每一个细分 Socket 汇聚起来都是数十亿美元级的庞大市场。
5 大 XPU Attach 细分赛道深度剖析:
Custom NICs(定制网卡):从通用网卡向 400mm² 芯片巨兽的演进
从传统 100G 基础网卡全面转向集成定制网络协议、特定加速器的半定制 SmartNIC。Marvell 最新研制的定制网卡面积已突破 400mm²,成为高门槛的技术壁垒。
Memory Expansion(内存扩展):Structera X 与 Structera A 的双柱战略
针对“内存墙”,Marvell 推出 5nm Structera 系列 CXL 芯片,分为两大产品线:
Structera X:专注于 DDR5/DDR4 内存池化、数据压缩与内存回收。
Structera A:专注于近内存计算(Near-Memory Compute),直接在内存层级卸载 LLM 与 KV Cache 密集型算力需求。
Storage Controllers(存储控制器与加速器):掌控闪存与数据喂料流
提供半定制 5nm SSD 控制器与存储加速芯片,解耦闪存厂商绑定,确保海量 AI 训练数据无间断“喂料”给 XPU。
AI Infrastructure Management Silicon(AI 基础设施管理芯片):重磅新增的千倍算力赛道
行业痛点:传统服务器仅有约 150 个传感器;而现代 AI 服务器的传感器数量暴增至 1500+ 个,每天产生数百 MB 管理数据。传统 BMC 芯片计算能力不堪重负。
Marvell 解法:基于成熟的 5nm Octeon 技术,打造定制管理处理器,提供 10 倍以上的性能提升,防止单点故障导致数千颗 XPU 训练中断。
Inference Acceleration(推理加速器):定制 SRAM 与 3.5D 封装解法
集成超高密度 SRAM(带宽提升 17 倍,待机功耗降低 2/3)与 3.5D 封装技术(结合 3D 堆叠内存与逻辑裸片),专门针对特定工作负载提供片外推理加速。
顶级云巨头战略合作披露:
AWS:签署为期 5 年的深度战略协议,涵盖定制 AI 芯片、以太网交换、相干光及 CPO 技术。
NVIDIA:展开 NVLink Fusion 与 AI RAM 方面的深层光学与网络协作。
Google:披露未来 6.5 年内针对 TPU 生态的定制产品附带机会(XPU Attach)潜在规模高达 1200 亿美元。
6. 洞察五:“30 and 30”财务奇迹——TAM 暴涨4倍,2031财年冲刺800亿美元(Financial Blueprint & The "30 in 30" Rule)
注:Marvell 的财年计算较日历年提前约一年。例如 FY27 对应 CY2026(2025年2月-2026年1月),FY31 对应 CY2030。
基于连接与定制芯片双轮驱动,Marvell 提出了震撼华尔街的全新财务蓝图。
1. 可寻址市场(TAM)重新定义
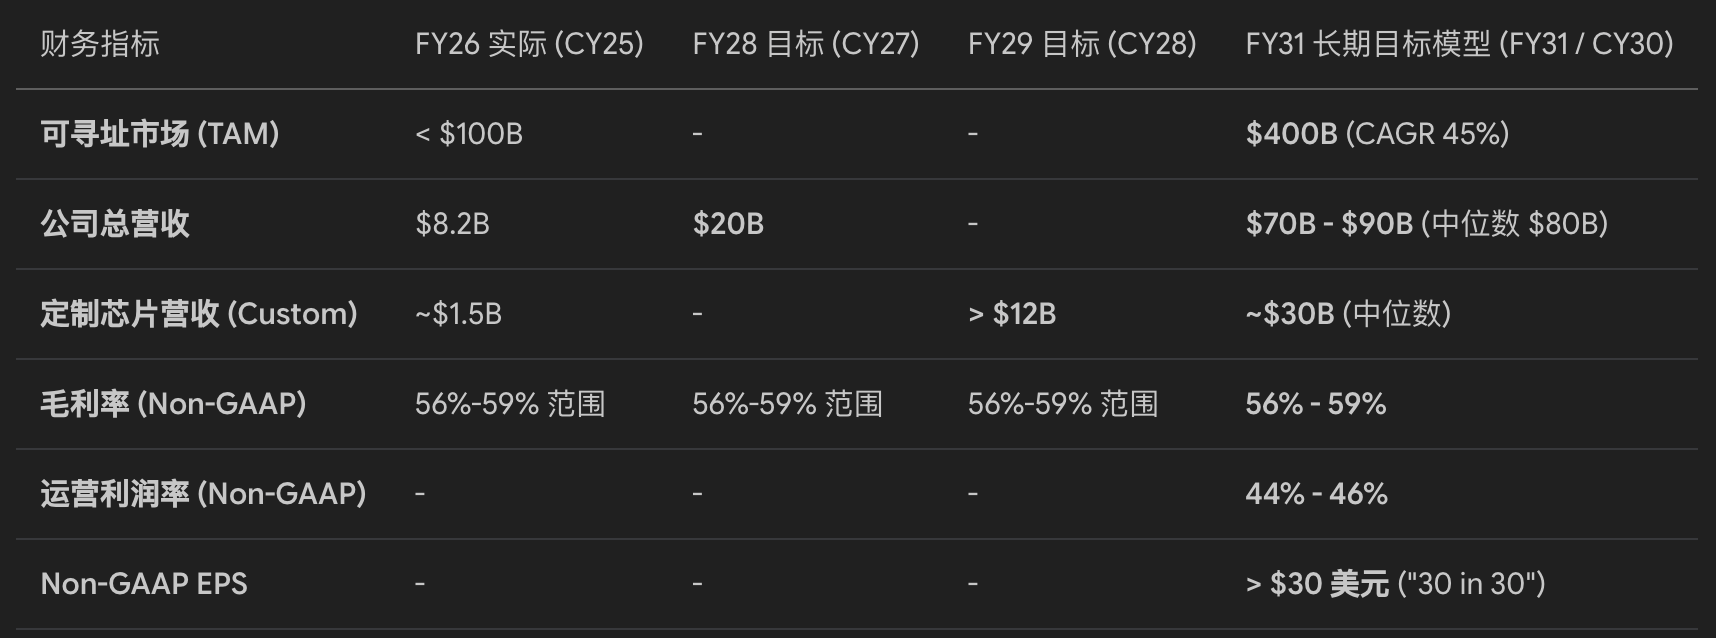
随着全球数据中心 Capex 预计在 2030 年(CY30/FY31)达到 3 万亿美元,Marvell 的可寻址市场(TAM)实现了翻天覆地的扩张:TAM 从此前评估的不足 $100B 飙升 4 倍至 4000 亿美元(2025-2030 年复合增长率高达 45%)。
2. 营收路线图拆解(Revenue Roadmap)
FY26:82 亿美元
FY27 预期:约 120 亿美元(同比大增 47%)
FY28 目标:200 亿美元(比前次指引上调 20 亿美元,数据中心业务占比达 180 亿美元)
FY29 定制芯片目标:从原先的 >10B 上调至 >12B(实现比 FY28 翻三倍)
FY31 远期目标:全公司营收冲刺 700-900 亿美元(中位数 800 亿美元),实现 5 年 10 倍的惊人跨越。其中定制芯片(Custom)业务将达到 ~$300 亿美元。
3. 财务模型的“对冲效应”与经营杠杆
新任 CFO Dan Durn 详细阐述了利润率背后的商业对冲逻辑:
毛利率(Gross Margin)56-59%:具有天然的业务组合对冲属性(Custom 占比提升时毛利偏低但客户承担 NRE 费用、研发占用少;Merchant 连接芯片占比提升时毛利偏高)。
运营支出(OpEx)杠杆:OpEx 增速仅为营收增速的一半,驱动运营利润率(Operating Margin)提升至 44-46%(比上一代长期目标整整提升了 6 个百分点)。
4. 终极财务指标:“30 in 30”法则
Dan Durn 将 Marvell 的远期盈利能力总结为极其简洁的**“30 in 30”法则**:在日历年 2030 年(FY31),Marvell 将实现 Non-GAAP 每股收益(EPS) > $30 美元。
7. 洞察六:重构半导体工程与供应链的“降维打击”法则(Engineering & Supply Chain Scaling)
要支撑从 80 亿到 800 亿美元的十倍跨越,单纯靠技术演进远远不够,必须重构半导体工程设计与供应链交付的底座。COO Chris Koopmans 揭示了 Marvell 的三大“软实力”武器:
1. 供应链信任重构(5年精准预测)
打破传统芯片业按季度或年度向晶圆厂/封装厂要产能的常规模式。Marvell 率先向台积电等核心供应商提供长达 5 年的精准数据驱动需求预测,并通过直接资本投入进行产能预订(Capacity Reservation)。这建立起了极高的生态互信与产能壁垒。
2. 全面拥抱云端 EDA(Cloud EDA)
Marvell 率先将 80% 以上的 EDA 计算部署在云端(AWS)。在实际研发中,面对突发的新设计需求,Marvell 能在 60 天内调配 30,000 核、90 天内调配 70,000 核云端算力,使一颗极其复杂的先进制程芯片在 9 个月内即完成 Tape-out(流片)。
3. AI 原生设计工具(Marvell Design Assistant)
Marvell 研发了自研 AI 设计助手(Design Assistant),将 AI Agent 深度整合至芯片设计、仿真与自动化修复流程中。实际数据显示,拥有 5 年经验的工程师在 AI 工具赋能下,能够产出以往需要 15 年资深工程师才能完成的设计成果,大幅缩短了产品迭代周期。
8. 总结与前瞻:站在下一个十年的新起点(Conclusion & Forward-Looking Reflection)
纵观 Marvell 投资者日展现的全景蓝图,其最核心的底层商业逻辑在于:Marvell 并没有押注在某一颗具体的 XPU 赢家身上,而是在为整个 AI 产业搭建无处不在的光电连接基础设施。
在未来的 AI 军备竞赛中,无论主流算力最终属于 NVIDIA 的 GPU、Google 的 TPU,还是各大云厂商自研的 Custom ASIC,只要数据需要跨越距离流动,只要网络需要攻克“铜缆墙”与“内存墙”,每一条数据流动的路径上都必须依赖 Marvell 的连接芯片与光电引擎。
正如发布会结尾留给资本市场的深邃思考:
“当全市场都在为算力芯片的制程节点和单体性能疯狂争论时,我们是否忽略了那个真正连接物理世界与数字智能的‘光电桥梁’?”
