
 2
 0
今天的这篇的主题是: Demystifying Agent Skills: Why They Work—Until They Don’t
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
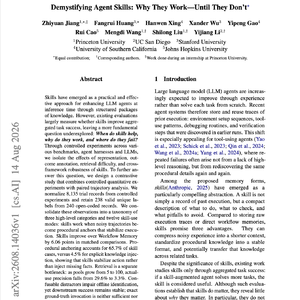
Skills 已成为一种实用且有效的方法,通过结构化的知识包在推理阶段增强大语言模型智能体的能力。然而,现有评估主要关注 Skills 是否能够提高任务的总体成功率,而对一个更根本的问题缺乏深入探索:* Skills 何时有效、为何有效,以及在何处失效? * 我们在不同基准测试、智能体运行框架(Agent Harness)和大语言模型上开展受控实验,以分离并考察 Skills 的表示形式、结果标注、检索难度以及跨框架鲁棒性所产生的影响。
为了进一步回答这一问题,我们设计了一项对比研究,将受控定量实验与成对执行轨迹分析相结合。我们对受控实验中的 8,135 条试验记录进行了标准化处理,并从 240 条开放式编码记录中保留了 238 个有效的唯一标签。我们将这些观察结果归纳为一个包含三个高层类别和十二种 Skill 使用模式的分类体系。
研究发现,当嘈杂的执行轨迹转化为能够稳定执行过程的程序性锚点时,Skills 便能发挥作用。在匹配条件下的比较中,Skills 的表现比工作流记忆(Workflow Memory)高出 6.06 个百分点。程序性锚定(Procedural Anchoring)占 Skill 使用案例的 65.7%,而显式知识注入仅占 4.5%,这表明 Skills 的主要作用是稳定行动过程,而非注入缺失的事实知识。
检索是一个独立的瓶颈:随着 Skill 候选池规模从 5 增加到 100,实际使用精确率从 29.6% 下降至 3.3%。容易混淆的干扰项会削弱离线识别效果,但下游任务成功率仍保持稳定;准确调用真实标注的 Skill 既不是任务成功的充分条件,也不是必要条件。当 Skills 依赖脆弱的假设、面临不兼容的上下文或缺乏充分的适应性调整时,就会失效。
这些发现推动 Skills 的评估超越总体成功率这一单一指标,并为构建可靠的自演化智能体提供了指导。
原文链接:arxiv.org
