
 0
 0
今天的这篇的主题是: The Compaction Cliff in Long-Running AI Agent Memory
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
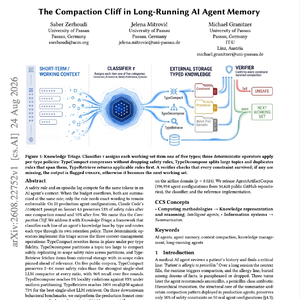
在 AI 智能体的上下文中,安全规则与情节式日志(Episodic Log)会竞争相同的 Token 预算。当上下文超出容量限制时,两者通常会以相同的压缩率进行摘要;然而,只有安全规则需要保留精确的措辞,才能确保其持续得到执行。
在 20 个生产级智能体配置上,我们发现,Claude Code 的 /compact 提示词在 Sonnet 4.6 上经过一轮上下文压缩后,仅能保留 53% 的安全规则;经过五轮压缩后,这一比例进一步下降至 10%。我们将这一现象称为压缩悬崖(Compaction Cliff)。
为解决这一问题,我们提出了知识分诊(Knowledge Triage)框架。该框架根据类型对智能体知识库中的每一行内容进行分类,并为不同类型的信息分配各自的保留策略。
我们设计了三个确定性算子,分别对应三种上下文管理操作:
(1)TypeCompact:根据不同信息类型的保真度要求,直接在原位置重写内容。
(2)TypeDecompose:当某个主题过大、无法安全压缩时,将其划分为多个分区,并在各分区之间复制适用范围内的安全规则。
(3)TypeRetrieve:从外部存储中检索信息,并将适用范围内的安全规则置于相关性排序之前,确保其优先保留。
在五个公开语料库上的实验表明,TypeCompact 在所有压缩比例下保留的安全规则数量均为最强单轮 LLM 压缩器的 2–4 倍,并在五轮压缩后仍保持 96% 的召回率。TypeDecompose 将局部性违规率(Locality Violations)降至 0%,而统一分区方法的违规率高达 93%。TypeRetrieve 的 Recall@50 达到 100%,相比之下,最佳单轮 LLM 检索器仅达到 73%。
在三个下游行为基准测试中,我们的方法同样表现出优势:在医疗合规任务中,我们在规则保留方面显著优于生产环境使用的 Sonnet 压缩器(配对 McNemar 检验,p < 10⁻⁸,N = 200);在零售任务中,我们的任务通过率显著优于完整策略基线和层次化基线(p < 0.01,N = 115);在航空领域中,我们的方法也显著优于层次化压缩方法(p = 0.024)。
我们开源了 AgentArtifactCorpus 数据集(包含来自 54,628 个公开 GitHub 代码仓库的 396,934 个智能体配置)、分类器以及参考实现。
原文链接:arxiv.org
