
 226
 0
【赞助商】
通勤路上就听AI每周谈。AI每周谈,每周带你回顾上周AI大事
传送门 🔗www.xiaoyuzhoufm.com
【目录】
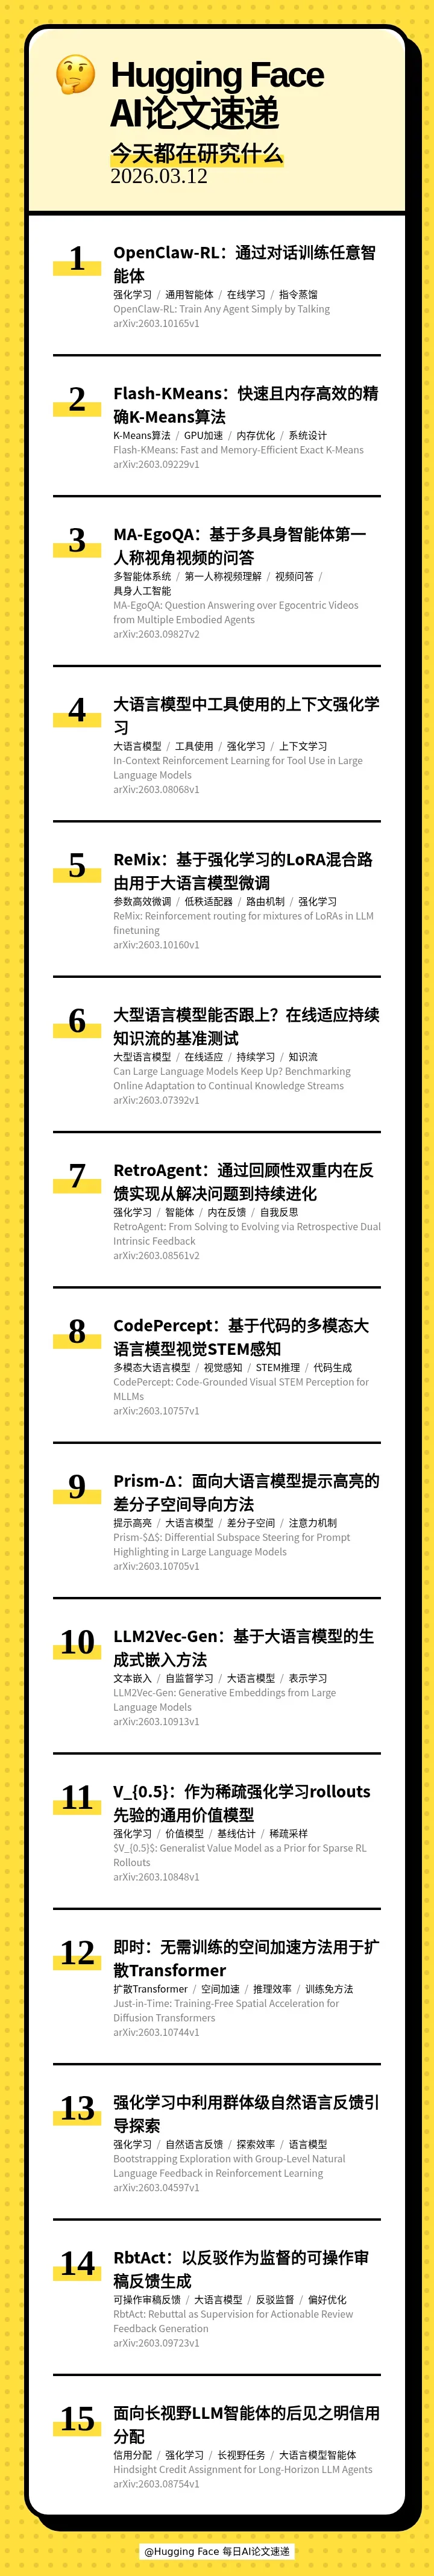
本期的 15 篇论文如下:
00:29 🤖 OpenClaw-RL: Train Any Agent Simply by Talking(OpenClaw-RL:通过对话训练任意智能体)
01:17 ⚡ Flash-KMeans: Fast and Memory-Efficient Exact K-Means(Flash-KMeans:快速且内存高效的精确K-Means算法)
02:01 👁 MA-EgoQA: Question Answering over Egocentric Videos from Multiple Embodied Agents(MA-EgoQA:基于多具身智能体第一人称视角视频的问答)
02:43 🧠 In-Context Reinforcement Learning for Tool Use in Large Language Models(大语言模型中工具使用的上下文强化学习)
03:19 🧠 ReMix: Reinforcement routing for mixtures of LoRAs in LLM finetuning(ReMix:基于强化学习的LoRA混合路由用于大语言模型微调)
04:10 📊 Can Large Language Models Keep Up? Benchmarking Online Adaptation to Continual Knowledge Streams(大型语言模型能否跟上?在线适应持续知识流的基准测试)
05:00 🧠 RetroAgent: From Solving to Evolving via Retrospective Dual Intrinsic Feedback(RetroAgent:通过回顾性双重内在反馈实现从解决问题到持续进化)
05:50 🔬 CodePercept: Code-Grounded Visual STEM Perception for MLLMs(CodePercept:基于代码的多模态大语言模型视觉STEM感知)
06:44 🎯 Prism-$Δ$: Differential Subspace Steering for Prompt Highlighting in Large Language Models(Prism-Δ:面向大语言模型提示高亮的差分子空间导向方法)
07:31 🧠 LLM2Vec-Gen: Generative Embeddings from Large Language Models(LLM2Vec-Gen:基于大语言模型的生成式嵌入方法)
08:22 ⚖ $V_{0.5}$: Generalist Value Model as a Prior for Sparse RL Rollouts(V_{0.5}:作为稀疏强化学习rollouts先验的通用价值模型)
09:05 ⚡ Just-in-Time: Training-Free Spatial Acceleration for Diffusion Transformers(即时:无需训练的空间加速方法用于扩散Transformer)
09:47 🧠 Bootstrapping Exploration with Group-Level Natural Language Feedback in Reinforcement Learning(强化学习中利用群体级自然语言反馈引导探索)
10:39 💬 RbtAct: Rebuttal as Supervision for Actionable Review Feedback Generation(RbtAct:以反驳作为监督的可操作审稿反馈生成)
11:14 🧠 Hindsight Credit Assignment for Long-Horizon LLM Agents(面向长视野LLM智能体的后见之明信用分配)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
