
 275
 6
DeepSeek 涨价了——涨幅最猛的不是生成回答,而是一行你可能根本没注意过的东西:Cache Hit,涨了整整 6 倍。这行数字背后藏着三个字母:KV Cache。
这期我们从那封没有数字的涨价邮件讲起,一路往下挖到 GPU 显存的物理层:为什么 AI 记住的东西越多就越贵?为什么 DeepSeek 涨了 6 倍还比 Claude 便宜 43 倍?用酒店比喻拆解 KV Cache 五大压缩流派——架构、量化、驱逐、稀疏、卸载——的技术混战,再拉回到你今天下班前就能做的三个检查项。最后聊一个让人着迷的问题:当 AI 的记忆无限便宜,真正稀缺的变成了什么?
=====================================
时间轴
00:00 开篇引子:DeepSeek V4-Pro涨价事
01:29 大模型最贵的不是思考,而是记忆
03:12 DeepSeek V4‑Pro 价目表
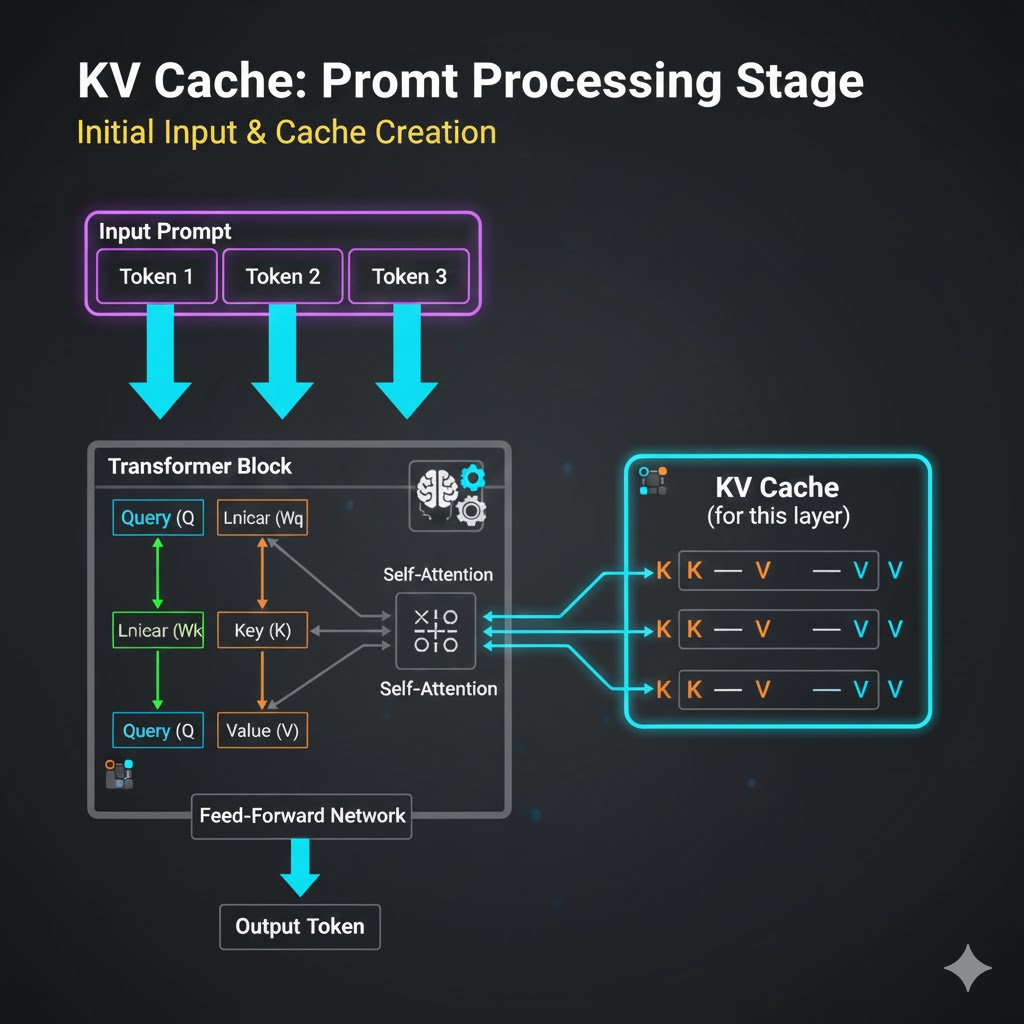
04:33 KV Cache是什么
08:57 两大基础定价机制拆解
14:01 KV-Cache五大压缩流派
15:02 流派1| 架构派
18:51 流派2|量化派
22:16 流派3|驱逐派
25:58 流派4|稀疏注意力派
26:43 流派5 | 卸载派
30:02 工程落地层:推理框架、缓存新方案
34:35 调度层优化
35:49 必做3项落地检查清单
38:04 产业视角与未来趋势
45:00 结尾总结
46:14 片尾曲 suno.com
=====================================
vLLM: Efficient Memory Management for Large Language Model Serving with PagedAttention (SOSP 2023)
SGLang: Efficient Execution of Structured Language Model Programs (Zheng et al.)
TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate (ICLR 2026)
H₂O: Heavy-Hitter Oracle for Efficient Generative Inference (NeurIPS 2023)
StreamingLLM: Efficient Streaming Language Models with Attention Sinks
PagedEviction: Structured Block-wise KV Cache Pruning for Efficient LLM Inference
ShadowKV: KV Cache in Shadows for High-Throughput Long-Context LLM Inference (字节)
CacheBlend: Fast Large Language Model Serving for RAG with Cached Knowledge Fusion (EuroSys 2025)
NVIDIA ICMSP Explained: KV Cache NVMe Offload, 5x Inference Gains, and Setup Guide (2026)
=====================================
前游戏开发者,现海外云厂商架构师 [反向弯曲] 主理的 [AI×游戏] 播客!
帮助互联网|游戏从业人员
拆解全球游戏 AI 前沿动态,深挖技术落地干货。
让你轻松拿捏行业脉搏,预判 AI + 游戏的 "下一帧"。
对未来好奇?速戳订阅!
小红书b站同名:反向弯曲